 CARLOS DIEGO C. P.
SaaS Factory (A serie) · Parte 3 de 3
SaaS Factory (A série) — Particionamento de dados: Estratégias de Armazenamento em SaaS (Parte 3/3)
Neste post, falaremos sobre Particionamento de Dados e Estratégias de Armazenamento em SaaS.
Palavras-chave
Neste post, falaremos sobre Particionamento de Dados e Estratégias de Armazenamento em SaaS.
Como um princípio geral de arquitetura, os desenvolvedores normalmente tentam introduzir camadas ou estruturas que centralizam e abstraem aspectos horizontais de suas aplicações. O objetivo aqui é centralizar e padronizar políticas e estratégias de resolução de inquilinos. Você pode, por exemplo, introduzir um acesso a dados camada que injetaria contexto de inquilino em solicitações de acesso a dados. Isso seria simplificar o desenvolvimento e limitar a percepção do desenvolvedor sobre como a identidade do locatário flui através do sistema.
Ter essa camada instalada também oferece mais opções para políticas e estratégias que podem variar de inquilino para inquilino. Também cria um ambiente natural oportunidade de centralizar a configuração e o rastreamento da atividade de armazenamento.
Modelo de Silo de Conta Vinculada
Antes de nos aprofundarmos nas especificidades de cada serviço de armazenamento, vejamos como você pode usar AWS Linked Accounts para implementar o modelo de silo sobre qualquer uma das soluções de armazenamento da AWS. Para obter um silo com essa abordagem, sua solução precisa para provisionar uma conta vinculada separada para cada locatário. Isso pode realmente atingir um silo porque toda a infraestrutura de um inquilino é completamente isolada outros inquilinos.
A abordagem de conta vinculada depende do recurso de faturamento consolidado que permite que os clientes associem contas filhas a uma conta pagante geral. A ideia aqui é que, mesmo com contas vinculadas separadas para cada inquilino, a cobrança desses locatários ainda é agregada e apresentada como parte de uma única fatura para a conta do pagador.
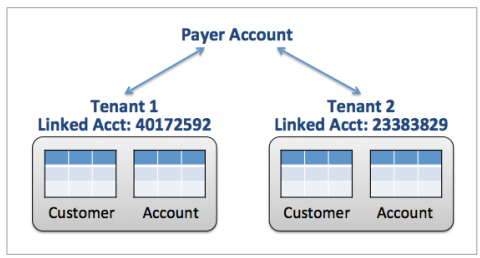
*Modelo Silo com contas vinculadas*
À primeira vista, isso pode parecer uma estratégia muito atraente para os provedores de SaaS que exigem um ambiente de silo. Certamente pode simplificar alguns aspectos de gestão e migração de inquilinos individuais. Montando uma visão do seus custos do inquilino também seriam mais diretos porque você pode resumir as despesas da AWS no nível da conta vinculada.
Mesmo com essas vantagens, o modelo de silo com conta vinculada tem importantes limitações. O provisionamento, por exemplo, é certamente mais complexo. Além de criando a infraestrutura do inquilino, você precisa automatizar a criação de cada conta vinculada e ajuste os limites que forem necessários. O desafio maior, no entanto, é escala. A AWS tem restrições quanto ao número de contas vinculadas que você pode criar, e esses limites provavelmente não se alinharão com ambientes que serão criando um grande número de novos inquilinos SaaS.
Multitenancy no DynamoDB
A natureza de como os dados são definidos e gerenciados pelo DynamoDB adiciona algumas novas reviravoltas em como você aborda a multilocação. Embora alguns serviços de armazenamento se alinhem bem com as estratégias tradicionais de particionamento de dados, o DynamoDB tem um mapeamento um pouco menos direto para os modelos de silo, bridge e pool. Com o DynamoDB, você tem que considerar alguns fatores adicionais ao selecionar sua estratégia multitenant. As seções a seguir exploram os mecanismos da AWS comumente usados para realizar cada um dos esquemas de particionamento multitenant no DynamoDB.
Modelo Silo
Antes de ver como você pode implementar o modelo de silo no DynamoDB, você deve primeiro considerar como o serviço define e controla o acesso aos dados. Diferente RDS, o DynamoDB não tem noção de instância de banco de dados. Em vez disso, todas as tabelas criados no DynamoDB são globais para uma conta dentro de uma região. Que significa que cada nome de tabela nessa região deve ser exclusivo para uma determinada conta.
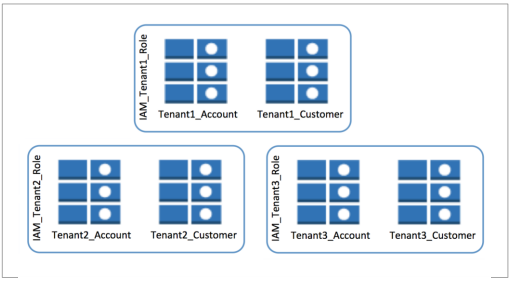
*Modelo Silo com tabelas do DynamoDB*
Se você implementar um modelo de silo no DynamoDB, precisará encontrar uma maneira de criar um agrupamento de uma ou mais tabelas associadas a um determinado inquilino. A abordagem também deve criar uma visão segura e controlada dessas tabelas para satisfazer os requisitos de segurança dos clientes do silo, evitando qualquer possibilidade de acesso a dados entre locatários. A figura mostra um exemplo de como você pode atingir esse escopo de locatário agrupamento de tabelas. Observe que duas tabelas são criadas para cada inquilino (Conta e Cliente). Essas tabelas também têm um identificador de inquilino que é anexado aos nomes das tabelas. Isso atende aos requisitos de nomenclatura de tabelas do DynamoDB e cria a ligação necessária entre as tabelas e seus inquilinos associados. O acesso a essas tabelas também é obtido por meio da introdução de políticas IAM. Seu processo de provisionamento precisa automatizar a criação de uma política para cada inquilino e aplicar essa política às tabelas pertencentes a um determinado inquilino.
Essa abordagem atinge os objetivos fundamentais de isolamento do modelo de silo, definindo limites claros entre os dados de cada inquilino. Também permite afinar e otimização em uma base inquilino por inquilino. Você pode ajustar duas áreas específicas:
- As métricas do Amazon CloudWatch podem ser capturadas no nível da tabela, simplificando a agregação de métricas de locatário para atividade de armazenamento.
- Capacidade de escrita e leitura da tabela, medida como entrada e saída por segundo (IOPS), são aplicadas ao nível da tabela, permitindo criar diferentes políticas de escalabilidade para cada locatário.
As desvantagens deste modelo tendem a ser mais no operacional e lado da gestão. Claramente, com esta abordagem, suas visões operacionais de um inquilino requerem algum conhecimento do esquema de nomenclatura da tabela de inquilinos para filtrar e apresentar informações em um contexto centrado no inquilino. A abordagem também adiciona uma camada de indireção para qualquer código que precise interagir com essas tabelas. Cada interação com uma tabela do DynamoDB exige que você insira o contexto do inquilino para mapeie cada solicitação para a tabela de locatário apropriada.
Os provedores de SaaS que adotam uma arquitetura baseada em microsserviços também têm outra camada de considerações. Com microsserviços, as equipes normalmente distribuem armazenamento responsabilidades para serviços individuais. Cada serviço tem a liberdade de determinar como ele armazena e gerencia os dados. Isso pode complicar seu isolamento histórico no DynamoDB, exigindo que você expanda sua população de tabelas para atender às necessidades de cada serviço. Ele também adiciona outra dimensão de escopo, onde cada tabela para cada serviço identifica sua vinculação a um serviço. Para compensar alguns desses desafios e alinhar-se melhor com o DynamoDB, considere ter uma única tabela para todos os seus dados de locatário. Esta abordagem oferece várias eficiências e simplifica o provisionamento, gerenciamento e perfil de migração de sua solução.
Na maioria dos casos, usar tabelas separadas do DynamoDB e políticas IAM para isolar seu os dados do inquilino atendem às necessidades do seu modelo de silo. Sua única outra opção é considere o modelo de silo de conta vinculada, descrito anteriormente. No entanto, conforme delineado anteriormente, o modelo de isolamento de conta vinculada vem com recursos adicionais limitações e considerações.
Modelo Bridge
Para o DynamoDB, a linha entre o modelo de bridge e o modelo de silo é muito tênue. Essencialmente, se seu objetivo usando o modelo de bridge é ter uma única conta com variação de esquema única para cada cliente, você pode ver como isso pode ser alcançado com o modelo de silo descrito anteriormente.
Para o bridge, a única questão seria se você poderia relaxar um pouco do requisitos de isolamento descritos com o modelo de silo. Você pode conseguir isso por eliminando a introdução de quaisquer políticas IAM em nível de tabela. Assumindo o seu inquilinos não exigem isolamento total, você pode argumentar que a remoção do IAM políticas podem simplificar seu esquema de provisionamento. No entanto, mesmo no bridge, há méritos no isolamento. Portanto, embora descartar o isolamento do IAM possa ser atraente, ainda é uma boa prática de SaaS alavancar construções e políticas que podem restringir o acesso entre inquilinos.
Modelo Pool
A implementação do modelo de pool no DynamoDB exige que você volte atrás econsidere como o serviço gerencia os dados. Como os dados são armazenados no DynamoDB, o serviço deve avaliar e particionar continuamente os dados para alcançar a escala. E se o perfil de seus dados é distribuído uniformemente, você pode simplesmente confiar nisso esquema de particionamento subjacente para otimizar o perfil de desempenho e custo de seus locatários SaaS.
O desafio aqui é que os dados em um ambiente SaaS multilocatário não têm normalmente uma distribuição uniforme. Locatários SaaS vêm em todas as formas e tamanhos e, como tal, seus dados são tudo menos uniformes. É muito comum para vendedores SaaS acabarem com um punhado de inquilinos que consomem a maior parte da sua pegada de dados.
Sabendo disso, você pode ver como isso cria problemas para implementar o modelo pool em cima do DynamoDB. Se você simplesmente mapear identificadores de locatário para uma chave de partição do DynamoDB, descobrirá rapidamente que também cria partições “pontos quentes”. Imagine ter um inquilino muito grande que prejudicaria a forma como o DynamoDB particiona efetivamente seus dados. Esses pontos quentes podem afetar o custo e desempenho da sua solução. Com a distribuição abaixo do ideal das suas chaves, você precisa aumentar o IOPS para compensar o impacto de suas partições quentes. Esta necessidade de IOPS mais alto se traduz diretamente em custos mais altos para sua solução.
Para resolver este problema, você deve introduzir algum mecanismo para controlar melhor a distribuição de seus dados de locatário. Você precisará de uma abordagem que não dependa de um único identificador de locatário para particionar seus dados. Todos esses fatores levam a um caminho único — você deve criar um modelo de sharding secundário para associar cada inquilino com várias chaves de partição.
Vejamos um exemplo de como você pode dar vida a essa solução. Primeiro, você precisa de uma tabela separada, que chamaremos de “tabela de pesquisa de inquilino”, para capturar e gerenciar o mapeamento de inquilinos para seu DynamoDB correspondente chaves de partição. A figura a seguir representa um exemplo de como você pode estruturar seu tabela de pesquisa de locatário.
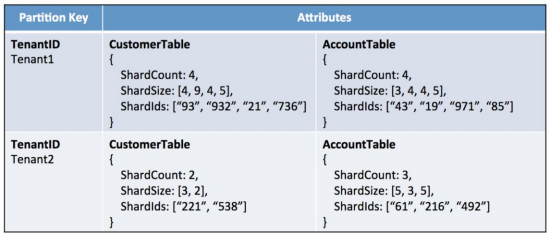
*Tabela de Pesquisa de Inquilino*
Esta tabela inclui mapeamentos para dois inquilinos. Os itens associados a esses os inquilinos têm atributos que contêm informações de fragmentação para cada tabela que é associado a um inquilino. Aqui, nossos inquilinos têm informações de fragmentação para suas tabelas Cliente e Conta. Observe também que para cada tabela de inquilinos combinação, existem três informações que representam o atual perfil de sharding para uma tabela. Esses são:
- ShardCount: Uma indicação de quantos fragmentos estão atualmente
associado à tabela;
- ShardSize: O tamanho atual de cada um dos fragmentos;
- ShardIds: Uma lista de chaves de partição mapeadas para um inquilino (para uma tabela).
Com esse mecanismo instalado, você pode controlar como os dados são distribuídos para cada tabela. A indireção da tabela de pesquisa oferece uma maneira de ajustar dinamicamente esquema de fragmentação de um locatário com base na quantidade de dados que está armazenando.
Inquilinos com uma pegada de dados particularmente grande receberá mais fragmentos. Porque o modelo configura a fragmentação tabela por tabela, você tem muito mais controle granular sobre o mapeamento das necessidades de dados de um locatário para uma fragmentação específica configuração. Isso permite que você alinhe melhor seu particionamento com o natural variações que costumam aparecer no perfil de dados do seu locatário.
Embora a introdução de uma tabela de pesquisa de inquilino forneça uma maneira de abordar distribuição de dados do locatário, ela não vem sem um custo. Este modelo agora introduz um nível de indireção que você deve abordar nos dados da sua solução camada de acesso. Em vez de usar um identificador de locatário para acessar diretamente seus dados, primeiro consulte os mapeamentos de fragmentos para esse inquilino e use a união desses identificadores para acessar seus dados de locatário. A amostra de tabela Customer na figura a seguir mostra como os dados seriam representados neste modelo.
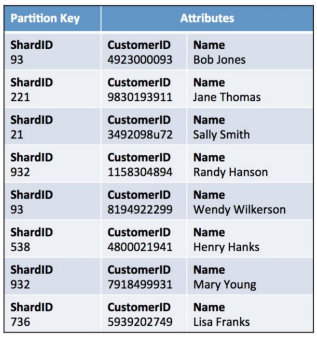
*Tabela de clientes com IDs de fragmentos*
Neste exemplo, o ShardID é um mapeamento direto da tabela mostrada na figura. Essa tabela de pesquisa de inquilinos incluía duas listas separadas de fragmentos identificadores para a tabela Customer, um para Tenant1 e outro para Tenant2. Esses identificadores de fragmentos se correlacionam diretamente com os valores que você vê neste exemplo mesa do cliente. Observe que o identificador real do inquilino nunca aparece nesta tabela do cliente.
Multitenancy no RDS
Com tantos sistemas SaaS anteriores entregues em bancos de dados relacionais, o comunidade de desenvolvedores estabeleceu alguns padrões comuns para endereço multilocação nesses ambientes. Na verdade, o RDS tem um mapeamento mais natural aos modelos silo, bridge e pool.
A construção e representação de dados no RDS é uma extensão do ambientes relacionais não gerenciados. Os mecanismos básicos disponíveis no MySQL, por exemplo, também estão disponíveis para você no RDS. Isso torna o realização de multitenancy em todos os tipos de RDS relativamente simples.
As seções a seguir descrevem as várias estratégias que são comumente empregado para realizar os modelos de particionamento no RDS.
Modelo Silo
Você pode obter o padrão de silo na AWS de várias maneiras. No entanto, o mais abordagem comum e mais simples para alcançar o isolamento é criar instâncias de banco de dados para cada inquilino. Através de instâncias, você pode atingir um nível de separação que normalmente satisfaz as necessidades de conformidade dos clientes sem a sobrecarga de provisionamento de contas totalmente separadas.
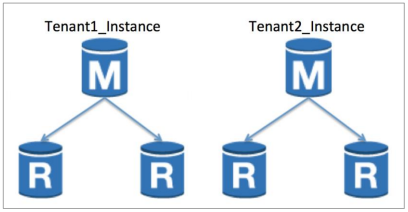
*Instâncias RDS como Silos*
Modelo Bridge
Alcançar o modelo de bridge no RDS se encaixa nos mesmos temas que vemos em todos os modelos de armazenamento. A abordagem básica é alavancar uma única instância para todos inquilinos enquanto cria representações separadas para cada inquilino dentro dessa base de dados. Isso introduz a necessidade de ter tabela de provisionamento e tempo de execução resolução para mapear cada tabela para um determinado inquilino.
O modelo bridge oferece a oportunidade de ter inquilinos com diferentes esquemas e alguma flexibilidade ao migrar dados de locatário. Você poderia, por exemplo, ter diferentes locatários executando diferentes versões do produto em um determinado momento no tempo e migrar gradualmente as mudanças de esquema em uma base de locatário-byte.
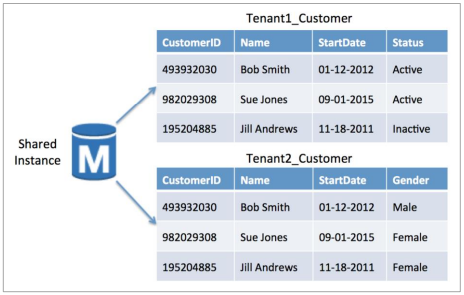
*Modelo Bridge no RDS*
Modelo Pool
O modelo de pool para RDS depende de esquemas de indexação relacional tradicionais para dados de locatário de partição. Como parte da transferência de todos os dados do locatário para um arquivo compartilhado modelo de infraestrutura, você armazena os dados do locatário em uma única instância RDS e o inquilinos compartilham tabelas comuns. Essas tabelas são indexadas com um inquilino exclusivo identificador que é usado para acessar e gerenciar os dados de cada locatário.
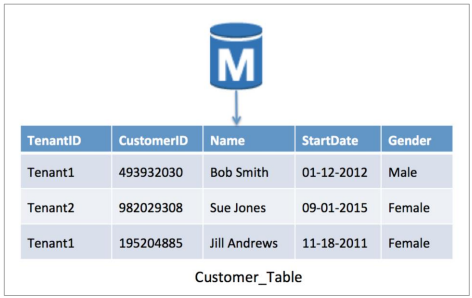
*Modelo de pool no RDS com esquema compartilhado*
De olho na agilidade
A matriz de opções de armazenamento multitenant pode ser assustadora. Pode ser desafiador identificar a solução que representa a melhor combinação de flexibilidade, isolamento e capacidade de gerenciamento. Embora seja importante considerar todas as opções, também é essencial fatorar continuamente a agilidade em seu armazenamento multilocatário pensando. O sucesso das organizações SaaS é muitas vezes fortemente influenciado pela quantidade de agilidade incorporada em sua solução.
A tecnologia de armazenamento e o modelo de isolamento que você seleciona afetam diretamente o seu capacidade de implantar facilmente novos recursos e funcionalidades. A forma do seu a estrutura e o conteúdo de seus dados geralmente mudam para oferecer suporte a novos recursos e isso significa que seu modelo de armazenamento subjacente deve acomodar essas mudanças sem exigir tempo de inatividade. Cada modelo de isolamento tem prós e contras quando vem para apoiar esta migração perfeita. Ao considerar suas opções, dê esses fatores o peso apropriado.
Conclusão
As necessidades de armazenamento dos clientes SaaS não são simples. A realidade do SaaS é que o domínio, os clientes e as considerações herdadas de sua empresa afetam como você determinar qual combinação de opções de armazenamento multilocatário atende melhor às necessidades do seu negócio.
Embora não haja uma estratégia única que se adapte universalmente a todos os ambientes, é claro que alguns modelos se alinham melhor com os princípios básicos da entrega de SaaS modelo. Em geral, as abordagens de armazenamento baseadas em pool — em qualquer armazenamento da AWS tecnologia — alinhar bem com a necessidade de uma abordagem unificada para gerenciar e operar um ambiente multitenant. Tendo todos os seus inquilinos em um compartilhado repositório e representação simplifica e unifica a sua abordagem pegada operacional e de implantação, permitindo visualizações de integridade entre locatários e desempenho.
Os modelos de silo e bridge certamente têm seu lugar e, para alguns fornecedores de SaaS, são absolutamente necessários. A chave aqui é que, se você seguir esse caminho, a agilidade pode ficar mais complicada. Algumas tecnologias de armazenamento da AWS são melhor posicionado para suportar esquemas de armazenamento de locatários isolados. Construindo um silo modelo no RDS, por exemplo, é menos complexo do que no DynamoDB. Geralmente, sempre que você contar com contas vinculadas como seu modelo de particionamento, você enfrentará mais desafios de provisionamento, gerenciamento e dimensionamento.
No próximo post, falaremos como implementar a arquitetura geral de Identidade e Acesso em soluções de software como serviço na AWS.
SaaS Factory (A série) — Como construir soluções de Software como Serviço na AWS
Até lá! =)
Comentários
Todo comentário passa por moderação antes de aparecer aqui. Nada é publicado automaticamente.
Carregando…