 CARLOS DIEGO C. P.
Publicação de Artigo · Artificial Intelligence
A Estrutura Econômica do Ecossistema de IA Generativa
Intensidade de Capital, Difusão de Capacidades e Diferenciação Competitiva ao Longo da Cadeia de Valor
Palavras-chave
Resumo
Ecossistemas de plataformas digitais construídos sobre IA generativa não são mercados únicos, mas cadeias de valor de seis camadas—abrangendo semicondutores, infraestrutura de nuvem, desenvolvimento de modelos de fundação, serviços de inferência, orquestração de plataformas e aplicações—nas quais as exigências de capital, as barreiras de entrada e os mecanismos de captura de valor diferem acentuadamente entre as camadas. Este artigo analisa a estrutura econômica desse ecossistema de negócios em rede por meio de uma revisão sistemática da literatura com 36 estudos, avalia seis hipóteses estruturais e apresenta três proposições formais que estendem a teoria de plataformas e os referenciais de ativos complementares a ecossistemas de IA com múltiplas camadas. Os resultados revelam uma assimetria estrutural: a concentração de capital coexiste com a rápida difusão de capacidades na camada de modelos e com barreiras de entrada substancialmente menores na camada de aplicações. As camadas de orquestração de plataformas apresentam a base teórica mais forte para a captura de valor à medida que as capacidades dos modelos se tornam commodities. Empresas que atuam em múltiplas camadas internalizam fluxos de valor entre camadas, o que explica por que a integração vertical confere vantagens competitivas duradouras que a competência técnica, por si só, não consegue replicar.
Palavras-chave: IA generativa, ecossistemas de plataformas digitais, cadeia de valor, teoria de plataformas, infraestrutura de IA, integração vertical, difusão de capacidades.
1. Introdução
A inteligência artificial generativa evoluiu para um ecossistema comercial de múltiplas camadas no qual a lógica da competição difere acentuadamente entre as camadas. Empresas que competem em hardware de semicondutores enfrentam uma estrutura de custos, uma dinâmica de concentração e um mecanismo de captura de valor diferentes daqueles enfrentados por empresas que competem no desenvolvimento de modelos de fundação, em serviços de inferência ou em aplicações a jusante. Ainda assim, a pesquisa existente trata esse ecossistema como uma categoria indiferenciada. Estudos sobre leis de escala da IA, dinâmicas de plataforma, efeitos de produtividade e riscos de governança abordam componentes individuais da pilha de forma isolada; nenhum deles os integra em um relato sistemático da estrutura econômica. Como resultado, as empresas carecem de um referencial analítico para decidir onde competir, como se posicionar entre as camadas ou por que estratégias de integração vertical produzem resultados diferentes do foco em uma única camada.
As propriedades estruturais que tornam esse ecossistema analiticamente distinto remontam ao surgimento dos modelos de fundação—grandes sistemas neurais treinados em conjuntos de dados amplos e adaptados a múltiplas tarefas a jusante (Bommasani et al., 2021). Três desenvolvimentos tecnológicos moldaram essas propriedades. Primeiro, a introdução da arquitetura transformer (Vaswani et al., 2017) e a subsequente demonstração de capacidades emergentes de aprendizado com poucos exemplos (*few-shot*) (Brown et al., 2020) estabeleceram um novo paradigma de sistemas de linguagem de propósito geral. Segundo, a pesquisa sobre leis de escala mostrou que o desempenho de modelos de fronteira é uma função previsível do investimento contínuo em computação (Kaplan et al., 2020; Hoffmann et al., 2022), tornando a intensidade de capital uma característica estrutural do ecossistema, e não uma condição transitória. Terceiro, a disponibilização desses modelos por meio de APIs padronizadas (OpenAI, 2023; Anthropic, 2023) criou uma cadeia de suprimentos em camadas na qual desenvolvedores a jusante podem acessar inteligência de propósito geral sem replicar a infraestrutura subjacente (Cusumano et al., 2025). Em conjunto, esses desenvolvimentos produziram um ecossistema caracterizado por concentração de capital na camada de infraestrutura, rápida difusão de capacidades na camada de modelos e condições de entrada assimétricas entre as camadas—exatamente a estrutura que este artigo analisa.
Esse ecossistema está hoje inserido em dinâmicas econômicas e de governança mais amplas. Pesquisadores documentaram riscos relacionados a vieses, desinformação e uso indevido (Bender et al., 2021), propuseram taxonomias de riscos de modelos de linguagem (Weidinger et al., 2022) e avaliaram práticas de transparência entre desenvolvedores de fronteira (Bommasani et al., 2023). Economistas examinaram como a IA reduz custos de predição (Agrawal et al., 2018), molda mercados de trabalho (Acemoglu e Restrepo, 2019) e gera efeitos de produtividade no trabalho do conhecimento (Noy e Zhang, 2023; Brynjolfsson et al., 2023). Estudiosos de plataformas mostraram que infraestruturas tecnológicas tendem a evoluir para mecanismos de coordenação multilaterais (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Cusumano et al., 2019). Trabalhos empíricos sobre mercados de LLMs mostram ainda que a competição nesses ecossistemas já é moldada por estratégias de preço, restrições de infraestrutura e intermediários de roteamento (Demirer et al., 2025). Este estudo integra essas vertentes em uma análise econômica unificada do ecossistema de IA generativa.
Apesar do rápido progresso nessas áreas, a literatura existente permanece fragmentada entre fronteiras disciplinares. A pesquisa em aprendizado de máquina concentra-se principalmente em capacidades algorítmicas e no escalonamento de modelos, enquanto os estudos econômicos enfatizam efeitos sobre a produtividade e o mercado de trabalho. A pesquisa sobre plataformas analisa dinâmicas de ecossistemas, mas raramente integra as restrições tecnológicas associadas ao desenvolvimento de IA. Da perspectiva dos sistemas de informação, a cadeia de valor da IA generativa representa uma nova classe de infraestrutura de negócios em rede cuja estrutura econômica determina como a competição entre plataformas digitais se desdobra entre as camadas—e, no entanto, não existe um relato integrado dessa estrutura fundamentado em sistemas de informação. Da perspectiva da organização industrial, o papel crescente da IA também pode remodelar estruturas de mercado, particularmente em setores caracterizados por fortes complementaridades entre plataformas de software e infraestrutura de nuvem (Varian, 2018).
De forma crucial, essa fragmentação se estende à literatura sobre ecossistemas tecnológicos e sistemas de inovação que é mais diretamente relevante para o argumento do artigo. A pesquisa sobre padrões setoriais de mudança técnica há muito tempo mostra que os setores diferem sistematicamente em seus regimes de apropriabilidade, barreiras de entrada e na relação entre intensidade de capital e captura de valor (Pavitt, 1984). O ecossistema de IA generativa exibe uma versão extrema desse padrão—com um dos gradientes de intensidade de capital mais acentuados já documentados em um setor tecnológico nascente—e, no entanto, nenhum estudo aplicou essa tradição analítica à sua estrutura. Da mesma forma, a teoria dos ativos complementares (Teece, 1986) prevê que a capacidade de lucrar com a inovação depende não da inovação em si, mas de quem controla os recursos complementares necessários para entregar valor; essa previsão tem implicações diretas sobre quais camadas da cadeia de valor da IA capturarão rendas à medida que as capacidades dos modelos se difundem, mas não foi aplicada a esse contexto. Mais recentemente, a teoria de ecossistemas de Jacobides, Cennamo e Gawer (Jacobides et al., 2018) desenvolve um referencial para compreender como empresas com diferentes posições arquiteturais capturam valor por meio do controle de gargalos e interfaces—um referencial que se aplica à cadeia de valor da IA generativa de maneiras que este artigo torna explícitas. Como resultado, a estrutura econômica mais ampla do ecossistema de IA generativa não foi analisada sistematicamente a partir da tradição dos estudos de inovação, que é a que melhor equipa os pesquisadores para abordá-la.
Este estudo preenche essa lacuna ao integrar contribuições do aprendizado de máquina, da economia de plataformas digitais e dos estudos de inovação. Ele faz três contribuições à literatura. Primeiro, propõe um modelo conceitual de seis camadas da cadeia de valor da IA generativa que organiza o ecossistema segundo função tecnológica, intensidade de capital, dinâmica competitiva e mecanismos de captura de valor—uma estrutura unificada que trabalhos anteriores não desenvolveram sistematicamente. Segundo, oferece uma avaliação empírica, fundamentada em teoria, de seis hipóteses estruturais sobre o ecossistema, mostrando quais afirmações são confirmadas, quais são parcialmente confirmadas e quais ainda precisam ser verificadas à medida que o mercado amadurece. Terceiro, estende a teoria de plataformas e a tradição dos estudos de inovação sobre ativos complementares e arquitetura de ecossistemas a um contexto de IA generativa com múltiplas camadas por meio de três proposições formais: a Proposição 1 (deslocamento de plataforma impulsionado pela difusão) estabelece que o poder de plataforma migra da camada de capacidade para a camada de orquestração à medida que as capacidades dos modelos se tornam commodities—uma extensão do referencial de ativos complementares de Teece (1986) a ecossistemas de sistemas que aprendem; a Proposição 2 (simultaneidade de plataformas em múltiplas camadas) identifica uma configuração estrutural que exige definições de mercado específicas por camada, ausentes dos modelos de ecossistema existentes (Jacobides et al., 2018); e a Proposição 3 (prêmio de integração) reformula a justificativa da integração vertical, da redução de custos para a internalização de rendas ao longo de gargalos entre camadas, levando a lógica de controle arquitetural de Jacobides et al. (2018) à configuração específica das cadeias de valor de IA.
Com base em uma revisão sistemática da literatura apresentada na Seção 2, o artigo desenvolve o modelo conceitual na Seção 3 e avalia as seis hipóteses a seguir, cada uma derivada da literatura teórica e empírica revisada:
- H1 A intensidade de capital está concentrada nas camadas de infraestrutura de computação e de treinamento de modelos de fronteira.
- H2 A oferta de computação é altamente concentrada, embora a concentração não seja absoluta nem irreversível.
- H3 As melhorias de capacidade dos modelos de fundação se difundem rapidamente pelo ecossistema, comprimindo preços e corroendo a exclusividade técnica.
- H4 As barreiras de entrada na camada de aplicações são substancialmente menores do que nas camadas de computação e de modelos, embora a dependência de plataformas continue alta.
- H5 As camadas de plataforma estão posicionadas para capturar uma parcela desproporcional do valor do ecossistema por meio de mecanismos de coordenação e roteamento.
- H6 A IA generativa produz ganhos de produtividade mensuráveis e heterogêneos no trabalho do conhecimento, e a distribuição desses ganhos entre empresas e setores é condicionada pela estrutura do lado da oferta da cadeia de valor—particularmente pelas condições competitivas nas camadas de inferência e de aplicações.
A Seção 4 avalia essas hipóteses à luz do corpus. A Seção 5 discute implicações para a teoria de plataformas, a política de inovação e a estrutura competitiva. A Seção 6 conclui com uma síntese dos resultados, das contribuições teóricas e das implicações para a pesquisa e a prática.
2. Revisão Sistemática da Literatura
Este estudo adota uma revisão sistemática da literatura (RSL) para identificar e organizar a literatura relevante para a estrutura tecnológica e econômica do ecossistema de IA generativa. O objetivo da revisão é integrar contribuições da pesquisa em aprendizado de máquina, da economia de plataformas digitais e dos estudos de inovação para sustentar o referencial conceitual desenvolvido neste artigo.
2.1. Desenho da Revisão
A revisão foi desenhada para capturar pesquisas interdisciplinares que abordam a IA generativa tanto da perspectiva tecnológica quanto da econômica. Como o fenômeno investigado neste estudo abrange múltiplos domínios de pesquisa—incluindo ciência da computação, sistemas de informação, organização industrial e economia da inovação—a revisão integra intencionalmente literatura desses campos.
O corpus final inclui 36 publicações lançadas entre 2014 e 2025. Destas, 20 são trabalhos revisados por pares (11 artigos em periódicos, 4 artigos em conferências e 5 livros acadêmicos); as 16 restantes são literatura cinzenta, composta por working papers de instituições de pesquisa reconhecidas (NBER, Harvard Business School), preprints do arXiv e relatórios técnicos de organizações de pesquisa em IA e da indústria. Essa distinção é mantida ao longo de toda a análise: afirmações empíricas derivadas de fontes de literatura cinzenta são tratadas como indicativas e qualificadas de acordo, enquanto as conclusões sobre padrões estruturais se apoiam na convergência de evidências entre tipos de fonte. A inclusão de literatura cinzenta é metodologicamente justificada pelo ritmo de desenvolvimento desse campo, no qual a publicação revisada por pares fica de 18 a 36 meses atrás dos fenômenos estudados; ela é declarada de forma transparente para permitir que os leitores avaliem de maneira independente a base de evidências de cada resultado.
Essa janela temporal foi escolhida porque abrange tanto a consolidação da pesquisa sobre ecossistemas de plataformas quanto o surgimento de arquiteturas neurais de larga escala e de modelos de fundação que sustentam os sistemas modernos de IA generativa. As buscas nas bases de dados foram realizadas entre janeiro e março de 2025. Todas as decisões de triagem e seleção foram tomadas pelo autor; as limitações decorrentes da avaliação por um único revisor são reconhecidas na Seção 5.4.
2.2. Fontes de Dados
O processo de busca recorreu a múltiplas fontes acadêmicas para capturar a natureza interdisciplinar do campo.
As principais bases de dados acadêmicas utilizadas na busca foram:
- ACM Digital Library
- IEEE Xplore
- ScienceDirect
Essas bases foram selecionadas porque contêm uma parcela substancial da pesquisa revisada por pares em ciência da computação, inteligência artificial, sistemas de informação e engenharia de software.
Para complementar essas fontes, publicações adicionais foram identificadas por meio de indexação cruzada entre bases e de buscas dirigidas nos principais periódicos científicos, anais de conferências, repositórios institucionais de pesquisa e relatórios técnicos de centros de pesquisa em IA e organizações da indústria consolidados. Os veículos complementares incluíram *Science*, *Nature*, *Journal of Economic Perspectives*, *Research Policy*, *Strategic Management Journal*, a série de working papers do NBER, os working papers da Harvard Business School e relatórios técnicos de instituições de pesquisa em IA reconhecidas. A inclusão de *Research Policy* e *Strategic Management Journal* como veículos complementares foi deliberada: o enquadramento teórico do estudo se apoia em tradições dos estudos de inovação (padrões setoriais de mudança técnica, ativos complementares, arquitetura de ecossistemas) publicadas principalmente nesses periódicos, e excluí-los sub-representaria sistematicamente a base teórica mais relevante para as contribuições do artigo.
2.3. Estratégia de Busca
A estratégia de busca combinou palavras-chave associadas a cinco dimensões analíticas relevantes para este estudo:
- IA generativa e grandes modelos de linguagem
- infraestrutura de IA e escalonamento computacional
- ecossistemas de plataformas e mercados digitais
- implicações econômicas e de produtividade da inteligência artificial
- economia da inovação, padrões setoriais de mudança técnica e ativos complementares
As strings de busca combinaram termos como “large language models”, “foundation models”, “AI scaling laws”, “AI infrastructure”, “platform ecosystems”, “multi-sided platforms”, “AI productivity” e “AI economics”. Um exemplo de string composta aplicada aos campos de título, resumo e palavras-chave foi: (*“generative AI” OR “large language models” OR “foundation models”*) AND (*“platform ecosystems” OR “AI infrastructure” OR “AI economics” OR “AI productivity”*). As buscas foram aplicadas a títulos, resumos e palavras-chave. Apenas publicações em língua inglesa foram consideradas.
2.4. Critérios de Inclusão
As publicações foram incluídas na revisão se atendessem aos seguintes critérios:
- O estudo abordava ao menos uma das dimensões analíticas relevantes para esta pesquisa: fundamentos e arquiteturas de IA, escala e infraestrutura, ecossistemas de plataformas digitais ou impactos econômicos da adoção de IA.
- A publicação apresentava contribuições conceituais, empíricas ou técnicas diretamente relevantes para a compreensão da estrutura ou da dinâmica do ecossistema de IA generativa.
- A publicação apareceu em um veículo acadêmico ou institucional reconhecido, incluindo periódicos revisados por pares, anais de conferências, livros acadêmicos, séries de working papers, relatórios institucionais de pesquisa ou relatórios técnicos com autoria e metadados bibliográficos identificáveis. Esse critério abrange explicitamente working papers de instituições de pesquisa reconhecidas, como a Harvard Business School e o National Bureau of Economic Research, bem como relatórios técnicos de organizações consolidadas da indústria cujo trabalho informa diretamente a análise empírica da infraestrutura de IA e das dinâmicas de mercado.
- A publicação estava dentro da janela temporal de 2014–2025.
Os critérios de inclusão foram intencionalmente amplos para capturar a natureza interdisciplinar da pesquisa em IA generativa, que abrange ciência da computação, economia e gestão de tecnologia.
2.5. Critérios de Exclusão
Os seguintes critérios de exclusão foram aplicados durante o processo de triagem:
- Publicações focadas exclusivamente em melhorias algorítmicas pontuais, sem implicações mais amplas para infraestrutura, ecossistemas ou dinâmicas de mercado.
- Fontes não acadêmicas, como posts de blog, matérias de imprensa, materiais promocionais ou artigos de opinião sem transparência metodológica.
- Publicações sem autoria, veículo de publicação ou consistência bibliográfica identificáveis.
- Registros duplicados recuperados em múltiplas bases de dados.
Fontes de literatura cinzenta—working papers, preprints do arXiv, relatórios técnicos institucionais e relatórios anuais de empresas—não foram excluídas em razão do tipo de publicação, mas foram submetidas a um limiar de relevância mais alto e sinalizadas separadamente no corpus (ver Seção 2.1). Afirmações empíricas derivadas exclusivamente de literatura cinzenta são tratadas como indicativas ao longo de toda a análise e explicitamente qualificadas no texto. Essa abordagem segue a prática estabelecida em domínios tecnológicos de rápida evolução, nos quais a publicação revisada por pares costuma ficar de 18 a 36 meses atrás dos fenômenos estudados.
2.6. Processo de Seleção
A busca retornou inicialmente 146 registros nas bases de dados selecionadas e nas fontes complementares. Após a remoção de 32 entradas duplicadas recuperadas em múltiplas bases, os 114 registros restantes foram triados com base em títulos e resumos para avaliar sua relevância para o escopo analítico da revisão.
Desses 114 registros, 50 foram excluídos na triagem de título e resumo, restando 64 publicações para avaliação do texto completo. A triagem do texto completo foi então conduzida para avaliar o alinhamento com os critérios de inclusão e exclusão definidos no protocolo da revisão. Nessa etapa, foram excluídas publicações focadas exclusivamente em melhorias algorítmicas pontuais, aplicações específicas de domínio sem implicações para o ecossistema ou sem transparência metodológica.
Esse processo resultou em um corpus final de 36 estudos (31 identificados pelo processo principal de triagem PRISMA, complementados por 5 estudos adicionais identificados por meio de busca dirigida de citações em fontes-chave dos estudos de inovação), que formam a base analítica da revisão sistemática da literatura apresentada neste artigo. A Figura 1 resume o processo de seleção dos estudos.
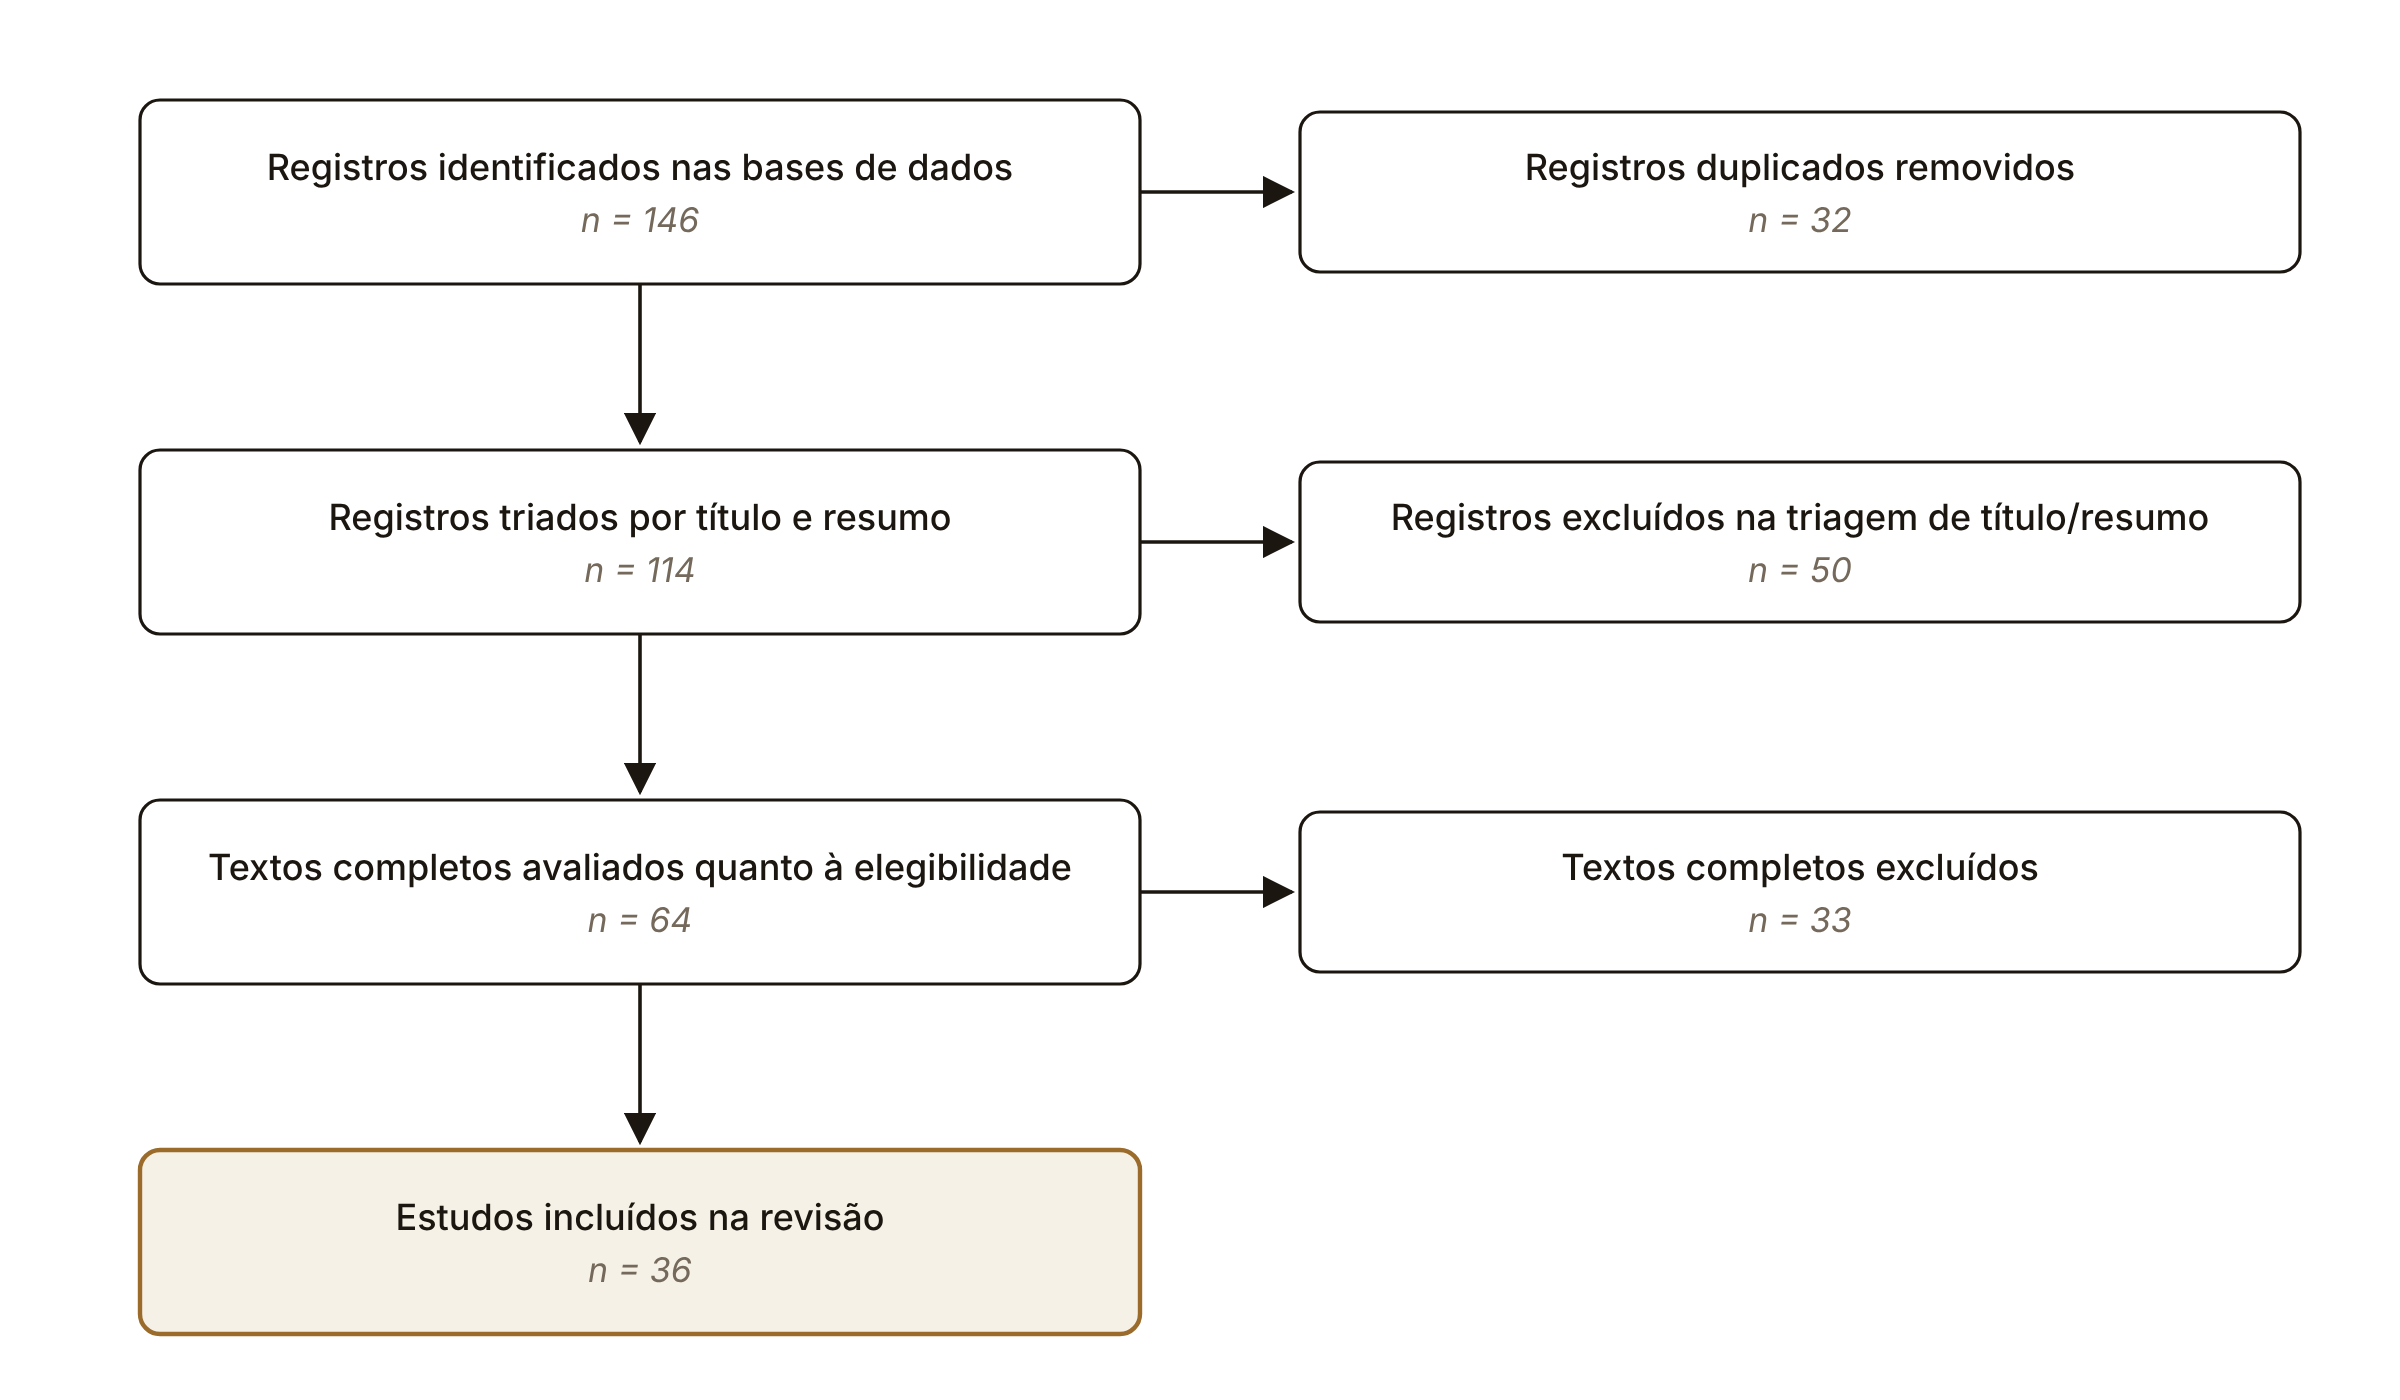
*Figura 1. Diagrama PRISMA do processo de seleção dos estudos.*
2.7. Organização do Corpus
Os estudos selecionados foram organizados em sete categorias temáticas que refletem as principais dimensões do ecossistema de IA generativa: fundamentos de IA, grandes modelos de linguagem e arquiteturas, infraestrutura e escala, riscos e governança de IA, ecossistemas de plataformas e mercados digitais, estudos de inovação e teoria de ecossistemas, e impactos econômicos e de produtividade.
A Tabela 1 resume os 36 estudos incluídos na revisão.
*Tabela 1. Estudos incluídos na revisão sistemática da literatura (36 estudos: 20 revisados por pares, 16 de literatura cinzenta/técnica).*
| Categoria | Estudos |
|---|---|
| Fundamentos de IA | (LeCun et al., 2015), (Goodfellow et al., 2016), (Jordan e Mitchell, 2015) |
| Grandes Modelos de Linguagem e Arquitetura | (Vaswani et al., 2017), (Brown et al., 2020), (Kaplan et al., 2020), (Hoffmann et al., 2022), (Bommasani et al., 2021), (OpenAI, 2023), (Anthropic, 2023) |
| Infraestrutura e Escala de IA | (Patterson et al., 2022), (NVIDIA Corporation, 2024) |
| Riscos e Governança de IA | (Bender et al., 2021), (Weidinger et al., 2022), (Bommasani et al., 2023) |
| Ecossistemas de Plataformas e Mercados Digitais | (Gawer, 2014), (Hagiu e Wright, 2015), (Evans e Schmalensee, 2016), (Cusumano et al., 2019), (Gawer e Cusumano, 2002), (Cusumano et al., 2025), (Cusumano, 2025), (Demirer et al., 2025) |
| Estudos de Inovação e Teoria de Ecossistemas | (Dosi, 1982), (Pavitt, 1984), (Teece, 1986), (Jacobides et al., 2018), (Cockburn et al., 2018) |
| Economia e Produtividade da IA | (Agrawal et al., 2018), (Acemoglu e Restrepo, 2019), (Brynjolfsson et al., 2017), (Noy e Zhang, 2023), (Peng et al., 2023), (Brynjolfsson et al., 2023), (Dell'Acqua et al., 2023), (Varian, 2018) |
3. Modelo Conceitual da Cadeia de Valor da IA Generativa
A revisão sistemática da literatura apresentada na Seção 2 indica que a IA generativa é mais bem compreendida não como uma categoria única de produto, mas como um sistema tecnológico e econômico em camadas. Os estudos existentes abordam partes individuais desse sistema, como o treinamento em larga escala (Kaplan et al., 2020; Hoffmann et al., 2022; Patterson et al., 2022), os modelos de fundação (Bommasani et al., 2021; OpenAI, 2023; Anthropic, 2023), as dinâmicas de plataforma (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Cusumano et al., 2019) e os efeitos econômicos da adoção de IA (Agrawal et al., 2018; Cockburn et al., 2018; Brynjolfsson et al., 2023). Evidências empíricas sobre a implantação de infraestrutura de IA e as dinâmicas de mercado ilustram ainda a intensidade de capital e a estrutura competitiva do setor (NVIDIA Corporation, 2024; Cusumano, 2025; Demirer et al., 2025). No entanto, essas dimensões raramente são integradas em um único modelo da cadeia de valor da IA generativa.
Para preencher essa lacuna, este artigo propõe um modelo conceitual da cadeia de valor da IA generativa. O modelo organiza o ecossistema em um conjunto de camadas interdependentes que diferem em função tecnológica, intensidade de capital, dinâmica competitiva e mecanismos de captura de valor. Essa perspectiva em camadas fornece a base analítica para avaliar as seis hipóteses apresentadas na Seção 1.
3.1. Justificativa para um Modelo em Camadas
A perspectiva da cadeia de valor é adequada porque os sistemas de IA generativa dependem de uma sequência de atividades tecnológicas e organizacionais complementares. O progresso em uma camada frequentemente depende de capacidades e restrições localizadas em outra. Por exemplo, as melhorias de desempenho dos modelos dependem da escala computacional (Kaplan et al., 2020; Hoffmann et al., 2022); a disponibilidade de modelos por meio de APIs afeta as barreiras de entrada para aplicações (Bommasani et al., 2021); e a captura de valor em ecossistemas digitais frequentemente depende do controle da plataforma, e não da propriedade de um único componente técnico (Gawer, 2014; Hagiu e Wright, 2015).
O ecossistema de IA generativa é, portanto, mais bem compreendido como uma pilha estruturada do que como um mercado indiferenciado. As camadas inferiores fornecem insumos computacionais e de infraestrutura essenciais. As camadas intermediárias transformam esses insumos em capacidades de modelos de propósito geral. As camadas superiores coordenam o acesso, a integração e as aplicações a jusante.
3.2. Camadas da Cadeia de Valor da IA Generativa
O modelo proposto é composto por seis camadas:
- Semicondutores e hardware especializado
- Infraestrutura de nuvem e de data centers
- Desenvolvimento de modelos de fundação
- Inferência e disponibilização de modelos
- Plataformas e ecossistemas de desenvolvedores
- Aplicações e soluções específicas de domínio
Embora essas camadas sejam analiticamente distintas, elas são economicamente interdependentes.
3.3. Semicondutores e Hardware Especializado
A primeira camada consiste nas tecnologias de semicondutores necessárias para executar cargas de trabalho de IA em escala. Isso inclui GPUs e outros aceleradores especializados usados para treinar e operar grandes redes neurais. Essa camada é analiticamente central: a pesquisa demonstra que o desempenho dos modelos melhora com o acesso à computação (Kaplan et al., 2020; Hoffmann et al., 2022), e evidências empíricas documentam a escala da infraestrutura de hardware necessária para sustentar cargas de trabalho de IA de fronteira (NVIDIA Corporation, 2024). Sem hardware especializado, o treinamento e a implantação de modelos de fronteira seriam inviáveis.
Essa camada é caracterizada por altos custos fixos, exigências de fabricação especializada e forte concentração tecnológica. Essas propriedades fazem dela um dos segmentos mais intensivos em capital do ecossistema de IA generativa.
3.4. Infraestrutura de Nuvem e de Data Centers
Acima da camada de hardware está a camada de infraestrutura de nuvem e de data centers. Esse segmento inclui clusters de computação em hiperescala, sistemas de armazenamento, interconexões de rede, ferramentas de orquestração e operações de data center intensivas em energia. A pesquisa sobre os custos computacionais e energéticos do treinamento de grandes redes neurais demonstra que cargas de trabalho de fronteira exigem recursos substanciais (Patterson et al., 2022; NVIDIA Corporation, 2024).
Essa camada transforma recursos de hardware em ambientes computacionais utilizáveis para treinamento e inferência de modelos. É também onde as economias de escala se tornam especialmente pronunciadas, uma vez que a eficiência de grandes clusters distribuídos depende da gestão integrada de recursos de computação, armazenamento e rede (Varian, 2018; NVIDIA Corporation, 2024).
3.5. Desenvolvimento de Modelos de Fundação
A terceira camada consiste nas organizações que desenvolvem modelos de fundação. Esses modelos são treinados em conjuntos de dados grandes e heterogêneos e projetados para dar suporte a muitas tarefas a jusante (Bommasani et al., 2021). Sistemas recentes como o GPT-4 e o Claude ilustram o papel dessa camada como produtora de capacidades generativas de propósito geral (OpenAI, 2023; Anthropic, 2023).
Essa camada é estrategicamente central porque define as capacidades essenciais disponibilizadas aos usuários a jusante. Ao mesmo tempo, permanece estreitamente ligada às camadas inferiores, já que o desenvolvimento de modelos depende de escala computacional, disponibilidade de dados e eficiência de treinamento.
3.6. Inferência e Disponibilização de Modelos
A quarta camada diz respeito à entrega operacional das capacidades dos modelos por meio de sistemas de inferência. Isso inclui a implantação, a otimização e a precificação do acesso aos modelos por meio de APIs e frameworks de disponibilização. A economia dessa camada difere da do treinamento. O treinamento exige grande investimento inicial, enquanto a inferência converte as capacidades dos modelos em serviços operacionais contínuos.
Evidências recentes de mercado mostram que a competição nessa camada é moldada por preço, disponibilidade de modelos e diferenciação de serviço (Demirer et al., 2025). À medida que mais provedores oferecem capacidades comparáveis, a inferência está se tornando um dos principais locais de competição por preço e de padronização comercial.
3.7. Plataformas e Ecossistemas de Desenvolvedores
A quinta camada consiste nas plataformas que conectam as capacidades dos modelos a desenvolvedores, organizações e usuários. Essas plataformas incluem gateways de API, camadas de orquestração, ferramentas para desenvolvedores, frameworks de integração e interfaces de distribuição. A pesquisa sobre plataformas digitais mostra que essas camadas de coordenação frequentemente se tornam centrais para a criação e a captura de valor em ecossistemas tecnológicos (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Cusumano et al., 2019).
Trabalhos recentes sugerem que os sistemas de IA generativa estão evoluindo para esse tipo de estrutura de plataforma, na qual as capacidades dos modelos sustentam ecossistemas mais amplos de aplicações e serviços (Cusumano et al., 2025). Essa camada ganha importância estratégica porque pode reduzir atritos de troca, padronizar o acesso e moldar os termos sob os quais os complementadores participam do ecossistema.
3.8. Aplicações e Soluções Específicas de Domínio
A sexta camada consiste em aplicações que incorporam capacidades de IA generativa em fluxos de trabalho, produtos e casos de uso específicos. Exemplos incluem assistentes de programação, copilotos corporativos, ferramentas de atendimento ao cliente, aplicações de produtividade e sistemas específicos de domínio.
Em comparação com as camadas inferiores, esse segmento geralmente apresenta barreiras de entrada de capital fixo menores, porque os desenvolvedores podem acessar capacidades de IA por meio de plataformas e APIs, em vez de treinar modelos de forma independente. No entanto, a camada de aplicações também tende a ser altamente competitiva, já que muitas empresas podem construir sobre os mesmos modelos de fundação e a mesma infraestrutura subjacentes.
A sustentabilidade de longo prazo das empresas nessa camada pode, portanto, depender da integração aos fluxos de trabalho, do conhecimento de domínio, dos canais de distribuição e da retenção de usuários, e não de uma capacidade técnica exclusiva.
3.9. Características Estruturais entre as Camadas
O modelo em camadas implica que diferentes segmentos da cadeia de valor da IA generativa tendem a exibir propriedades econômicas diferentes.
Primeiro, a intensidade de capital está concentrada nas camadas inferiores. Hardware e infraestrutura de nuvem exigem grandes investimentos fixos e capacidades especializadas. O desenvolvimento de modelos de fundação também continua caro, porque depende de acesso contínuo a computação em larga escala.
Segundo, a difusão de capacidades é mais visível nas camadas de modelos e de inferência (Camadas 3–4). Uma vez que arquiteturas de modelos, métodos de treinamento e abordagens de alinhamento se tornam mais amplamente conhecidos, organizações concorrentes podem replicar ou aproximar capacidades semelhantes (Cusumano, 2025; Demirer et al., 2025).
Terceiro, as barreiras de entrada nas camadas superiores são menores, mas a coordenação e a captura de valor podem se deslocar para intermediários de plataforma. A pesquisa sobre plataformas estabelece que as camadas que controlam a participação no ecossistema, as interfaces e as interações estão posicionadas para capturar uma parcela desproporcional do valor econômico (Gawer, 2014; Hagiu e Wright, 2015; Cusumano et al., 2025). Ao mesmo tempo, uma vez que capacidades de propósito geral se tornam acessíveis por meio de APIs, os desenvolvedores de aplicações podem entrar com menor custo de capital, tornando a coordenação e a distribuição a principal base de diferenciação competitiva.
Essas três propriedades estruturais motivam a avaliação empírica conduzida na próxima seção.
3.10. Implicações para a Avaliação das Hipóteses
O modelo conceitual aqui desenvolvido fornece a base para interpretar as seis hipóteses apresentadas na Seção 1.
As duas primeiras hipóteses dizem respeito às camadas inferiores da pilha, onde a infraestrutura de computação e o hardware especializado moldam a intensidade de capital e a concentração. A terceira hipótese diz respeito às camadas de modelos e de inferência (Camadas 3–4), onde a difusão de capacidades foi documentada empiricamente. A quarta e a quinta hipóteses dizem respeito às camadas superiores, onde as barreiras de entrada para aplicações e a coordenação de plataformas influenciam a captura de valor. A sexta hipótese conecta toda a cadeia de valor aos resultados de produtividade a jusante.
O modelo deixa claro, portanto, que a IA generativa é um ecossistema no qual as camadas tecnológicas são economicamente diferenciadas. Essa é a afirmação analítica central que a próxima seção avalia com base em evidências empíricas da literatura.
4. Avaliação Empírica das Hipóteses
4.1. Estratégia Analítica
Esta seção avalia as seis hipóteses apresentadas na Seção 1 com base no corpus sistemático definido na Seção 2 e no referencial da cadeia de valor apresentado na Seção 3. A base de evidências é heterogênea. Alguns estudos quantificam o comportamento de escala e as exigências de computação (Kaplan et al., 2020; Hoffmann et al., 2022; NVIDIA Corporation, 2024). Outros documentam preços, oferta e demanda em mercados de APIs de LLMs (Demirer et al., 2025). Um terceiro conjunto mede os efeitos de produtividade da IA generativa em contextos aplicados (Noy e Zhang, 2023; Peng et al., 2023; Brynjolfsson et al., 2023; Dell'Acqua et al., 2023). A questão empírica relevante não é se um único estudo comprova cada hipótese, mas se o conjunto das evidências aponta em uma direção consistente.
Duas ressalvas são necessárias. Primeiro, o mercado de IA generativa ainda está em um estágio inicial de desenvolvimento. Muitas das relações observadas são tendências estruturais, e não equilíbrios consolidados. Segundo, dados diretos de lucros e perdas por camada da cadeia de valor da IA generativa são escassos. A análise, portanto, se apoia em proxies observáveis: escala de computação, trajetórias de preço, concentração de mercado, padrões de entrada, concentração de uso e resultados de produtividade. Onde as evidências permitem, a discussão integra tanto resultados quantitativos quanto atributos estruturais qualitativos para avaliar cada hipótese.
4.2. H1 — A intensidade de capital está concentrada na infraestrutura de computação e no treinamento de modelos de fronteira
A H1 afirma que a intensidade de capital está concentrada nas camadas de infraestrutura e de modelos de fronteira. A base teórica dessa hipótese deriva da pesquisa sobre leis de escala, que mostra que o desempenho de modelos de fronteira é uma função do investimento contínuo em computação (Kaplan et al., 2020; Hoffmann et al., 2022), e da análise de organização industrial, que identifica altos custos fixos e insumos especializados como fontes estruturais de barreiras de entrada (Varian, 2018).
As evidências convergentes da pesquisa sobre escala e dos dados de infraestrutura confirmam a H1. Kaplan et al. mostram que o desempenho melhora com mais computação, maior tamanho de modelo e mais dados, enquanto Hoffmann et al. mostram que o treinamento competitivo só é ótimo em termos de computação sob um equilíbrio cuidadoso entre parâmetros e tokens (Kaplan et al., 2020; Hoffmann et al., 2022). Esses não são resultados técnicos abstratos: em termos econômicos, significam que a competição na fronteira exige investimento contínuo em capacidade de treinamento, e não experimentação isolada.
Os dados de infraestrutura da NVIDIA dão a escala dessa exigência. Segundo os relatórios da própria empresa, o segmento de data centers respondeu por aproximadamente 78% da receita total da NVIDIA no ano fiscal de 2024, e estimativas de terceiros sugerem que o treinamento de um modelo de fronteira como o GPT-4 exigiu da ordem de dezenas de milhares de GPUs e centenas de milhões de dólares em custo de computação—embora esses números não sejam divulgados oficialmente e devam ser interpretados como indicativos, e não precisos (NVIDIA Corporation, 2024). A pegada energética e de carbono do treinamento em larga escala fornece outra proxy da intensidade de recursos: Patterson et al. documentam os custos computacionais de grandes redes neurais de gerações anteriores, estabelecendo uma base metodológica para estimar a ordem de grandeza das exigências de treinamento de fronteira (Patterson et al., 2022). A montante, a concentração da fabricação de semicondutores avançados restringe ainda mais o acesso à capacidade de computação de fronteira (NVIDIA Corporation, 2024).
A análise de Cusumano sobre o DeepSeek refina, em vez de enfraquecer, esse resultado. Ela relata a alegação do próprio DeepSeek de cerca de US$ 5,6 milhões usando 2.000 GPUs H800, mas também cita estimativas externas de acesso a até 50.000 GPUs, mais de US$ 500 milhões em hardware de GPU e cerca de US$ 1,3 bilhão em custo de desenvolvimento mais amplo (Cusumano, 2025). A implicação metodológica é direta: as estimativas variam conforme se precifique uma única rodada de treinamento ou a base de capital necessária para tornar possíveis rodadas repetidas na fronteira.
A H1 é, portanto, confirmada.
4.3. H2 — A oferta de computação é concentrada, mas a concentração não é absoluta
A H2 afirma que a oferta de computação é altamente concentrada. A hipótese se fundamenta na teoria da organização industrial, que prevê que mercados com custos fixos extremamente altos e insumos especializados tendem à concentração (Varian, 2018), ao mesmo tempo que reconhece que a contestabilidade e o poder compensatório dos compradores podem moderar essa tendência.
As evidências sustentam uma narrativa de concentração, mas não de uma concentração irreversível. Segundo estimativas de analistas do setor citadas nas próprias comunicações da NVIDIA a investidores, a empresa detinha aproximadamente 98% do mercado de GPUs para data centers em 2023 (NVIDIA Corporation, 2024). Esse número é autodeclarado e não foi verificado de forma independente na literatura revisada por pares; deve ser interpretado como uma ordem de grandeza indicativa, e não como uma estatística de participação de mercado auditada com precisão. Há corroboração independente em sentido qualitativo: o segmento de data centers da NVIDIA respondeu por aproximadamente 78% da receita total da empresa no ano fiscal de 2024, e a ausência de fornecedores alternativos identificados com volume comparável é estruturalmente consistente com uma concentração extrema, ainda que o número exato da participação seja incerto (NVIDIA Corporation, 2024; Patterson et al., 2022).
Os mesmos dados mostram concentração do lado da demanda: alguns poucos provedores de nuvem em hiperescala respondem pela maior parte das compras de GPUs, e uma parcela substancial da receita de data centers da NVIDIA vem de um punhado de grandes clientes (NVIDIA Corporation, 2024). A estrutura de mercado resultante é bilateral, e não de base ampla, concentrada entre poucos grandes fornecedores e um número correspondentemente pequeno de compradores em hiperescala.
Ao mesmo tempo, as evidências mostram tentativas ativas de reduzir essa dependência. Os hyperscalers investiram no desenvolvimento de aceleradores de IA proprietários—como o AWS Trainium e o Inferentia e as TPUs do Google—como alternativas às GPUs de terceiros, com ganhos relatados de preço-desempenho para cargas de trabalho selecionadas (NVIDIA Corporation, 2024). Esses números devem ser interpretados com cautela, pois alguns derivam de benchmarks de desempenho dos próprios fabricantes. Ainda assim, mostram que os hyperscalers não se comportam como se a camada de computação estivesse permanentemente fechada.
O comportamento de preços da NVIDIA merece atenção analítica específica. As margens brutas da NVIDIA em GPUs para data centers foram relatadas acima de 70%, e a empresa manteve preços premium mesmo com a aceleração da demanda dos hyperscalers (NVIDIA Corporation, 2024). Essa postura de preços não é explicada diretamente apenas pela pressão competitiva. Uma parte substancial da durabilidade da NVIDIA deriva do CUDA, sua plataforma proprietária de computação paralela e interface de programação. Como o CUDA está profundamente incorporado à pilha de software de aprendizado de máquina—frameworks de treinamento, bibliotecas de inferência, cadeias de ferramentas de desenvolvimento e fluxos de trabalho de pesquisa foram construídos em torno dele por mais de uma década—, trocar para um hardware alternativo implica não apenas custos de substituição do hardware, mas custos de migração de software substancialmente mais difíceis de quantificar e de suportar. O CUDA funciona, portanto, como um ativo complementar que estende o poder de preço da NVIDIA além do que a concentração de hardware, sozinha, sustentaria (NVIDIA Corporation, 2024; Cusumano et al., 2019).
Essa estrutura sugere uma lógica estratégica consistente com a economia do monopólio durável sob competição antecipada. Um incumbente que espera ver sua liderança técnica se desgastar ao longo do tempo tem um incentivo racional para extrair rendas de forma agressiva enquanto sua vantagem se mantém, em vez de precificar para dissuadir a entrada. As evidências disponíveis são consistentes com essa interpretação, embora não estabeleçam de forma definitiva a intenção estratégica: evidências diretas do raciocínio estratégico interno da NVIDIA—como declarações de executivos que vinculem especificamente a estratégia de preços à comoditização antecipada do hardware—não estão disponíveis na literatura acadêmica aqui revisada. A interpretação deve, portanto, ser tratada como uma hipótese analiticamente motivada sobre a posição competitiva da NVIDIA, e não como uma conclusão demonstrada. O que as evidências mostram é o seguinte: os hyperscalers estão investindo em alternativas proprietárias precisamente porque os custos das GPUs são proibitivamente altos (NVIDIA Corporation, 2024); alternativas de código aberto, como a arquitetura do DeepSeek, demonstram que capacidades de qualidade de fronteira podem ser reproduzidas com custo de computação substancialmente menor (Cusumano, 2025); e os dados do mercado de inferência mostram que a disponibilização de modelos está se tornando uma commodity (Demirer et al., 2025). A expansão observável da NVIDIA para software e serviços—ferramentas do ecossistema CUDA, frameworks de inferência e parcerias de GPU em nuvem—é estruturalmente consistente com uma empresa que desloca a captura de valor para cima na pilha antes que as margens de hardware se comprimam, independentemente de esse resultado ser fruto de estratégia deliberada ou de resposta racional a sinais de mercado.
Essa observação traz uma implicação mais ampla para a H2. A concentração documentada na camada de computação é real, mas não é um equilíbrio estático. Ela reflete uma janela temporalmente delimitada na qual uma única empresa controla um insumo necessário enquanto os compradores a jusante ainda não escalaram alternativas viáveis. A vantagem do incumbente é durável no curto prazo, devido à dependência do CUDA, mas estruturalmente contestada no médio prazo, à medida que grandes compradores desenvolvem capacidades próprias e frameworks de computação de código aberto amadurecem.
Demirer et al. revelam uma segunda distinção notável: o número de provedores de inferência cresceu de 27 para 90 ao longo de 2025, e alguns modelos de código aberto estavam disponíveis em mais de 20 provedores (Demirer et al., 2025). A concentração é mais forte onde as restrições de capital físico e de fabricação são mais rígidas; é mais fraca onde a disponibilização padronizada de modelos pode ser sobreposta a uma infraestrutura compartilhada.
*Tabela 2. Evidências relevantes para a H2: concentração na oferta de computação.*
| Dimensão | Resultado quantitativo | Fonte | Interpretação |
|---|---|---|---|
| Participação no mercado de GPUs para data centers | ~98% de participação da Nvidia | (NVIDIA Corporation, 2024) | Forte concentração de fornecedores de aceleradores |
| Fabricação de lógica de ponta | >90% de participação em fábricas avançadas | (NVIDIA Corporation, 2024) | Forte concentração da fabricação a montante |
| Propriedade de clusters de fronteira | Pequeno número de hyperscalers responde pela maior parte das compras de GPUs | (NVIDIA Corporation, 2024) | Demanda concentrada entre hyperscalers |
| Concentração de receita | Parcela substancial da receita da Nvidia vem de poucos clientes de data center | (NVIDIA Corporation, 2024) | Concentração bilateral na oferta e na demanda |
| Crescimento dos provedores de inferência | 27 → 90 provedores em 2025 | (Demirer et al., 2025) | A camada de serviço é menos concentrada que a de treinamento |
| Modelos abertos com múltiplos hosts | Alguns modelos servidos por >20 provedores | (Demirer et al., 2025) | A abertura amplia a competição na camada de inferência |
As evidências disponíveis, portanto, não sustentam a visão de que a camada de computação é monopolizada, mas sim de que ela é altamente concentrada nos níveis de hardware e de treinamento de fronteira, ao mesmo tempo que se torna mais plural no nível do serviço de inferência.
A Tabela 2 resume as evidências quantitativas revisadas para a H2.
A H2 é parcialmente confirmada.
4.4. H3 — A difusão de capacidades é rápida e comercialmente relevante
A H3 afirma que as melhorias nas capacidades dos modelos de fundação se difundem rapidamente pelo ecossistema. A hipótese se apoia na economia da difusão do conhecimento (Cockburn et al., 2018) e na observação da teoria de plataformas de que, uma vez que as capacidades se tornam amplamente acessíveis, a competição se desloca da exclusividade técnica para preço, integração e serviços complementares (Gawer, 2014; Cusumano et al., 2019).
As evidências mais fortes vêm da evolução do mercado documentada por Demirer et al. Ao longo de 2025, o número de modelos aumentou de cerca de 253 para mais de 651, o número de criadores de modelos subiu de 43 para 85 e o número de provedores de inferência subiu de 27 para 90 (Demirer et al., 2025). Esses números indicam um ecossistema em rápida renovação técnica e comercial, incompatível com uma interpretação de difusão lenta.
O mesmo estudo documenta uma compressão de preços drástica: modelos que eram sistemas de fronteira em 2023 tiveram quedas de preço da ordem de 1000× até 2025 (Demirer et al., 2025). Esse número requer uma qualificação metodológica: Demirer et al. medem o preço por token a um determinado nível de inteligência medida, o que significa que a comparação controla pela capacidade, em vez de comparar preços nominais de modelos específicos ao longo do tempo. A magnitude é, portanto, em parte função de como a capacidade é medida e de como a fronteira é definida em cada momento. Mesmo com essas ressalvas, o resultado direcional—de que os prêmios de escassez associados à capacidade de fronteira se desgastam rapidamente—é corroborado pelos dados de preço independentes da análise de Cusumano sobre o DeepSeek e é consistente com a economia geral de setores intensivos em conhecimento (Cockburn et al., 2018). Deve-se notar também que Demirer et al. é um working paper no momento desta redação e seus resultados estão sujeitos a revisão por pares; a análise aqui trata seus resultados quantitativos como indicativos, e não definitivos.
A análise de Cusumano sobre o DeepSeek oferece uma ilustração concreta desse processo. O V3 e o R1 alcançaram desempenho em benchmarks próximo ao de modelos proprietários de fronteira, cobrando preços de API radicalmente menores: US$ 0,07 por milhão de tokens de entrada e US$ 0,11 por milhão de tokens de saída para o V3, e US$ 0,55 por milhão de tokens de entrada e US$ 2,19 por milhão de tokens de saída para o R1, em comparação com US$ 15 e US$ 60 por milhão de tokens para o GPT-4 na época da comparação (Cusumano, 2025). Mesmo considerando as limitações dos benchmarks, o diferencial de preço é comercialmente significativo.
Ao mesmo tempo, a difusão não é uniforme entre os casos de uso. Demirer et al. mostram que nenhum modelo isolado domina todas as tarefas, que a programação tende a usar modelos mais próximos da fronteira e que categorias como roleplay e tradução recorrem mais fortemente a modelos de menor inteligência (Demirer et al., 2025). A difusão de capacidades, portanto, não elimina a segmentação; ela estreita a exclusividade técnica enquanto preserva uma demanda diferenciada.
*Tabela 3. Evidências relevantes para a H3: difusão de capacidades e compressão de preços.*
| Métrica | Resultado quantitativo | Fonte | Interpretação |
|---|---|---|---|
| Número de modelos | 253 → 651 em 2025 | (Demirer et al., 2025) | Rápida expansão da oferta |
| Número de criadores | 43 → 85 em 2025 | (Demirer et al., 2025) | A capacidade de fronteira não está mais restrita a poucos laboratórios |
| Número de provedores | 27 → 90 em 2025 | (Demirer et al., 2025) | Difusão comercial por meio dos mercados de disponibilização |
| Queda de preço de modelos que eram de fronteira | ~1000× | (Demirer et al., 2025) | A capacidade de fronteira perde escassez rapidamente |
| Diferença de preço entre modelos abertos e fechados | Modelos abertos ~90% mais baratos com inteligência similar | (Demirer et al., 2025) | A difusão de capacidades remodela os preços de mercado |
| Preços da API do DeepSeek | V3: $0,07/$0,11; R1: $0,55/$2,19; GPT-4: $15/$60 | (Cusumano, 2025) | Capacidade próxima da fronteira pode se difundir por meio de desafiantes de baixo preço |
A Tabela 3 consolida as métricas quantitativas que sustentam a H3.
A H3 é confirmada.
4.5. H4 — As barreiras de entrada na camada de aplicações são substancialmente menores, mas a dependência de plataformas continua alta
A H4 afirma que as barreiras de entrada são menores na camada de aplicações do que nas camadas de computação ou de modelos. A base teórica deriva da estrutura em camadas da cadeia de valor da IA generativa: uma vez que as capacidades dos modelos de fundação estão acessíveis por meio de interfaces padronizadas, os atores a jusante podem integrá-las sem replicar de forma independente a infraestrutura subjacente (Bommasani et al., 2021; Cusumano et al., 2025). Essa lógica é paralela ao princípio geral da economia de plataformas segundo o qual os participantes das camadas superiores se apoiam nas capacidades das camadas inferiores sem arcar com seus custos de capital (Gawer, 2014; Cusumano et al., 2019).
As evidências empíricas disponíveis confirmam a H4. O argumento econômico central para barreiras de entrada menores na camada de aplicações é comparativo: construir uma capacidade de IA de fronteira exige investimento contínuo na casa das centenas de milhões de dólares (NVIDIA Corporation, 2024; Cusumano, 2025), enquanto acessar essa mesma capacidade por meio de uma API não exige nenhum dispêndio de capital além do custo marginal dos tokens consumidos. Essa assimetria de custos significa que organizações sem acesso a computação de fronteira—a vasta maioria das empresas—podem, ainda assim, construir aplicações habilitadas por IA, uma condição estruturalmente impossível antes do surgimento das APIs de modelos (Bommasani et al., 2021; Cusumano et al., 2025). A análise de plataformas do MIT confirma isso: modelos fechados acessados por API podem ser usados por organizações que não têm infraestrutura de computação nem equipes de aprendizado de máquina, permitindo que aluguem inteligência sob demanda em vez de produzi-la internamente (Cusumano et al., 2025).
O rápido crescimento da atividade na camada de aplicações é consistente com essa condição estrutural, embora meça experimentação, e não entrada comercial no sentido econômico. Após a introdução dos GPTs customizados, aproximadamente 3 milhões de versões customizadas foram criadas em dois meses (Cusumano et al., 2025)—um número que reflete a baixa barreira à prototipagem, e não o número de entrantes comercialmente viáveis. Demirer et al. fornecem evidências complementares sobre a especialização do lado da demanda: a programação responde por cerca de 50% do uso de tokens, enquanto roleplay e tecnologia respondem, cada um, por aproximadamente 15% (Demirer et al., 2025), indicando uma rápida formação de categorias em torno de aplicações de alto uso.
Ainda assim, a queda das barreiras de entrada não deve ser superestimada. Barreiras menores para construir não significam barreiras menores para distribuição, confiança, integração aos fluxos de trabalho ou monetização. O mesmo ecossistema de aplicações é fortemente mediado por plataformas que padronizam APIs, roteamento, preços e descoberta (Cusumano et al., 2025; Demirer et al., 2025). A camada de aplicações é mais fácil de entrar tecnicamente, mas continua dependente de interfaces controladas por plataformas.
*Tabela 4. Evidências relevantes para a H4: condições de entrada na camada de aplicações.*
| Métrica / característica | Resultado quantitativo | Fonte | Interpretação |
|---|---|---|---|
| Criação de GPTs customizados | ~3 milhões em 2 meses | (Cusumano et al., 2025) | Rápida experimentação na camada de aplicações |
| Participação da programação no uso de tokens | ~50% | (Demirer et al., 2025) | O desenvolvimento de aplicações responde rapidamente a APIs de modelos acessíveis |
| Participação do roleplay no uso de tokens | ~15% | (Demirer et al., 2025) | A experimentação com aplicações não corporativas também é substancial |
| Participação de tecnologia no uso de tokens | ~15% | (Demirer et al., 2025) | O uso está concentrado em poucas categorias |
A Tabela 4 resume as evidências para a H4.
A H4 é confirmada.
4.6. H5 — A camada de plataforma tem a base mais forte para a captura de valor, mas as evidências diretas sobre a alocação de valor continuam limitadas
A H5 afirma que a camada de plataforma tende a capturar uma parcela desproporcional do valor no ecossistema de IA generativa. A fundamentação teórica é bem estabelecida: plataformas multilaterais criam valor ao coordenar interações entre grupos de usuários e podem extrair rendas ao controlar acesso, visibilidade, troca e participação (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Cusumano et al., 2019). À medida que as capacidades dos modelos se difundem e se tornam mais substituíveis, a teoria prevê que as camadas de coordenação devem se tornar mais, e não menos, centrais estrategicamente.
As evidências empíricas mais fortes são indiretas, mas significativas. O OpenRouter oferece uma API unificada entre múltiplos modelos e provedores, padroniza o acesso, expõe informações de preço e desempenho e cobra cerca de 5–5,5% em taxas, dependendo da modalidade de uso (Demirer et al., 2025). Trata-se de uma renda de coordenação: a plataforma não precisa ser dona do modelo subjacente para monetizar a interface de mercado.
A análise de plataformas do MIT trata os modelos de fundação e suas cadeias de ferramentas como uma nova plataforma de desenvolvimento de aplicações e argumenta que as empresas tendem a usar uma combinação de grandes modelos fechados e modelos abertos menores, o que eleva o valor estratégico da orquestração e da integração (Cusumano et al., 2025). À medida que a oferta de modelos se expande e os modelos se tornam mais substituíveis, a plataforma que coordena acesso, roteamento, governança e integração aos fluxos de trabalho se torna estrategicamente mais central.
Isso ainda não estabelece que a camada de plataforma captura a maior parcela do lucro. Dados financeiros transparentes entre camadas, que mostrem a alocação de valor entre fabricantes de chips, empresas de nuvem, criadores de modelos, intermediários de inferência e plataformas de aplicações, ainda não estão disponíveis. Mas os mecanismos de mercado observáveis apontam na mesma direção da teoria de plataformas.
*Tabela 5. Evidências relevantes para a H5: coordenação e monetização de plataformas.*
| Mecanismo de plataforma | Evidência quantitativa / observada | Fonte | Implicação econômica |
|---|---|---|---|
| Acesso unificado entre modelos | Interface padronizada para múltiplos modelos | (Demirer et al., 2025) | Reduz custos de busca e de troca |
| Monetização da plataforma | Taxa de ~5–5,5% sobre o uso | (Demirer et al., 2025) | A coordenação pode ser monetizada diretamente |
| Uso corporativo de múltiplos modelos | Combinação esperada de modelos fechados e abertos | (Cusumano et al., 2025) | Eleva o valor da camada de orquestração |
| Ecossistema de GPTs customizados | ~3 milhões de versões customizadas em 2 meses | (Cusumano et al., 2025) | O crescimento do ecossistema aumenta a relevância da plataforma |
A Tabela 5 reúne as evidências observáveis para a H5.
A H5 tem fundamentação teórica, mas a verificação empírica direta continua incompleta.
4.7. H6 — Os ganhos de produtividade são mensuráveis e heterogêneos
A H6 afirma que a IA generativa produz ganhos de produtividade mensuráveis e heterogêneos no trabalho do conhecimento, e que a distribuição desses ganhos entre empresas e setores é condicionada pela estrutura do lado da oferta da cadeia de valor. A primeira parte da hipótese se fundamenta na economia das tecnologias de propósito geral, que prevê que, uma vez que uma nova capacidade se torna amplamente acessível, efeitos de produtividade devem surgir nas tarefas para as quais a tecnologia é adequada (Brynjolfsson et al., 2017; Agrawal et al., 2018). A segunda parte—a afirmação sobre distribuição—decorre do modelo da cadeia de valor: se o acesso às capacidades é mediado por camadas de plataforma capazes de extrair rendas de coordenação (H5), e se os custos de inferência são moldados pela concentração de computação (H2), então os termos em que os ganhos de produtividade chegam aos usuários finais são determinados pela estrutura competitiva das camadas 4–6, e não apenas pela existência de modelos capazes.
Entre as seis hipóteses, a H6 é a que conta com as evidências empíricas mais diretas. Noy e Zhang mostram que participantes que usaram IA generativa concluíram tarefas de redação profissional 40% mais rápido e produziram textos avaliados com qualidade 18% superior (Noy e Zhang, 2023). Peng et al. constatam que desenvolvedores que usaram o GitHub Copilot concluíram tarefas de programação 55,8% mais rápido que o grupo de controle (Peng et al., 2023). Brynjolfsson, Li e Raymond, com dados de 5.172 agentes de suporte ao cliente, relatam ganhos médios de produtividade de aproximadamente 14%, com ganhos maiores para trabalhadores menos experientes (Brynjolfsson et al., 2023). Dell'Acqua et al. mostram que consultores que usaram IA concluíram 12,2% mais tarefas e 25,1% mais rápido, além de obterem avaliações de qualidade melhores nos casos relevantes (Dell'Acqua et al., 2023).
Esses tamanhos de efeito são economicamente significativos e consistentes em diversos contextos de tarefas, abrangendo experimentos de laboratório, experimentos de campo e desenhos quase-experimentais. Mas a literatura também mostra que os efeitos são heterogêneos. Os ganhos dependem da estrutura da tarefa, da habilidade de base do trabalhador e da compatibilidade do fluxo de trabalho com a assistência de LLMs. O enquadramento da “fronteira irregular” (*jagged frontier*) em Dell'Acqua et al. tem peso analítico particular: a IA generativa não melhora todo o trabalho do conhecimento por igual (Dell'Acqua et al., 2023).
*Tabela 6. Evidências relevantes para a H6: efeitos de produtividade da IA generativa.*
| Estudo | Contexto | Efeito quantitativo | Principal resultado qualitativo |
|---|---|---|---|
| Noy & Zhang (2023) | Tarefas de redação | 40% mais rápido; qualidade 18% maior | Ganhos fortes na produção de linguagem estruturada |
| Peng et al. (2023) | Programação com Copilot | 55,8% mais rápido | Grandes ganhos em tarefas de programação delimitadas |
| Brynjolfsson et al. (2023) | 5.172 agentes de suporte ao cliente | ~14% de produtividade em média | Trabalhadores menos experientes se beneficiam mais |
| Dell'Acqua et al. (2023) | Consultoria / trabalho do conhecimento | +12,2% tarefas; 25,1% mais rápido | Os ganhos variam acentuadamente por tipo de tarefa |
A IA generativa não transforma uniformemente todo o trabalho do conhecimento; as evidências sustentam a conclusão de que existem ganhos de produtividade mensuráveis, frequentemente grandes, em um subconjunto relevante de tarefas intensivas em conhecimento, e que esses ganhos são grandes o suficiente para ter consequências econômicas.
A Tabela 6 resume os estudos de produtividade que sustentam a H6.
Conectar a H6 ao modelo da cadeia de valor revela uma implicação estrutural que a literatura de produtividade, sozinha, não evidencia. A camada de aplicações (camada 6) e a camada de inferência (camada 4) são os principais mecanismos de entrega pelos quais os ganhos de produtividade chegam aos usuários finais. Isso significa que os efeitos de produtividade documentados na H6 dependem das condições competitivas nas camadas 4–6: à medida que os preços de inferência caem (H3) e as barreiras de entrada na camada de aplicações diminuem (H4), ferramentas de IA que aumentam a produtividade se tornam acessíveis a um conjunto mais amplo de empresas e trabalhadores. Inversamente, se a concentração de computação (H2) persistir e a dependência de plataformas (H5) se intensificar, o acesso à IA que aumenta a produtividade pode passar a ser mediado por intermediários de plataforma capazes de extrair rendas do lado da demanda. A H6, portanto, não pode ser lida isoladamente da estrutura do lado da oferta do ecossistema: a distribuição dos ganhos de produtividade entre empresas e setores depende de quem controla as camadas pelas quais esses ganhos são entregues.
A H6 é confirmada.
4.8. Avaliação Consolidada
*Tabela 7. Avaliação geral das hipóteses.*
| Hipótese | Avaliação | Principal base empírica |
|---|---|---|
| H1 — A intensidade de capital está concentrada na infraestrutura e no treinamento de modelos | Confirmada | (Kaplan et al., 2020; Hoffmann et al., 2022; Patterson et al., 2022; NVIDIA Corporation, 2024; Cusumano, 2025) |
| H2 — A oferta de computação é altamente concentrada | Parcialmente confirmada | (NVIDIA Corporation, 2024; Demirer et al., 2025) |
| H3 — As melhorias de capacidade se difundem rapidamente pelo ecossistema | Confirmada | (Demirer et al., 2025; Cusumano, 2025) |
| H4 — O desenvolvimento de aplicações tem barreiras de entrada menores | Confirmada | (Cusumano et al., 2025; Demirer et al., 2025) |
| H5 — As camadas de plataforma capturam valor desproporcional | Fundamentada teoricamente; empiricamente incompleta | (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Cusumano et al., 2019; Demirer et al., 2025) |
| H6 — A IA generativa aumenta a produtividade no trabalho do conhecimento | Confirmada | (Noy e Zhang, 2023; Peng et al., 2023; Brynjolfsson et al., 2023; Dell'Acqua et al., 2023) |
As conclusões empíricas mais fortes dizem respeito às H1, H3, H4 e H6. As mais incertas são a H2 e a H5, não porque a teoria seja fraca, mas porque o mercado ainda não amadureceu o suficiente para revelar resultados estáveis de longo prazo; preservar essa distinção fortalece a credibilidade analítica da avaliação. A Tabela 7 apresenta a avaliação consolidada.
5. Discussão e Implicações
5.1. Interpretando a Estrutura do Ecossistema de IA Generativa
A avaliação empírica da Seção 4 sustenta o modelo de seis camadas, mas também revela dinâmicas que o modelo estático não captura por completo. Três observações interpretativas estendem o modelo para além de sua descrição estrutural.
Primeiro, a cadeia de valor é estruturalmente assimétrica de uma maneira específica: as camadas com maior intensidade de capital (semicondutores, infraestrutura de nuvem) não são as mesmas camadas com maior potencial de captura sustentada de valor (camadas de orquestração e de plataforma). Essa assimetria tem uma implicação direta para a análise competitiva: as empresas que absorvem o maior investimento de capital não são necessariamente as que capturarão os maiores retornos econômicos à medida que o mercado amadurece. As evidências da H3 sugerem que as margens da camada de modelos vão se comprimir à medida que as capacidades se difundem, enquanto as camadas de orquestração podem manter rendas de coordenação mesmo quando as capacidades dos modelos subjacentes se tornam commodities. Esse descolamento entre intensidade de capital e captura de valor é estruturalmente distinto em relação a ecossistemas tecnológicos anteriores, nos quais os provedores de infraestrutura (por exemplo, operadoras de telecomunicações e provedores de computação em nuvem) normalmente capturavam renda proporcional à sua base de capital.
Segundo, o ecossistema de IA generativa é mais bem compreendido como um sistema em transição do que como um equilíbrio maduro. A concentração de computação documentada na H2 reflete as condições do período 2023–2025 e já está sendo contestada pelos programas de chips próprios dos hyperscalers e pela eficiência arquitetural demonstrada pelos modelos do DeepSeek (NVIDIA Corporation, 2024; Cusumano, 2025). Os efeitos de produtividade documentados na H6 refletem estudos de adoção em estágio inicial, cujas implicações de longo prazo para a estrutura organizacional e os mercados de trabalho permanecem em aberto (Brynjolfsson et al., 2017; Acemoglu e Restrepo, 2019). As conclusões analíticas extraídas desse período devem ser tratadas como tendências estruturais, e não como equilíbrios permanentes.
Terceiro, a pilha exibe uma lógica de estratificação competitiva na qual vantagens nas camadas inferiores criam opções—mas não garantias—nas camadas superiores. Uma empresa que controla a oferta de semicondutores tem vantagem estrutural, mas não converte automaticamente essa posição em retornos na camada de aplicações; a conversão exige investimento deliberado nas camadas intermediárias. Inversamente, uma empresa com forte presença na camada de aplicações, mas sem posição nas camadas inferiores, está exposta a riscos de dependência que podem ser explorados por concorrentes integrados. Essa lógica de opcionalidade em camadas está ausente tanto dos modelos-padrão de organização industrial (que tratam a estrutura de mercado como independente das camadas) quanto dos modelos de plataforma de camada única (que tratam a plataforma como unidade de análise).
Da perspectiva dos sistemas de informação, o modelo de seis camadas oferece uma contribuição que vai além da descrição de um único setor. A cadeia de valor da IA generativa é o primeiro caso de um ecossistema de plataforma digital no qual a capacidade central da plataforma—o modelo de fundação—é ela própria um sistema que aprende, em melhoria contínua e sujeito à rápida difusão de desempenho. A pesquisa anterior em sistemas de informação sobre ecossistemas de plataformas digitais (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Cusumano et al., 2019) desenvolveu seus referenciais em contextos nos quais a capacidade central da plataforma (um sistema operacional, um protocolo de marketplace, um grafo social) era relativamente estável entre versões principais, e nos quais a dinâmica principal era o acúmulo de complementadores e usuários em torno de uma interface fixa. O contexto da IA generativa viola esse pressuposto: a capacidade central melhora em ordens de grandeza em um único ano, difunde-se para implementações concorrentes quase imediatamente e, com isso, redefine continuamente o que conta como gargalo e o que conta como commodity. Isso tem implicações diretas para a pesquisa em sistemas de informação sobre governança de plataformas, padronização e estratégia competitiva: modelos calibrados em contextos de plataformas estáveis podem subestimar sistematicamente a velocidade com que o valor migra entre as camadas em ecossistemas de IA.
Os resultados também têm implicações para a forma como as organizações desenham suas estratégias de mercado digital em ambientes intensivos em IA. O modelo de seis camadas da cadeia de valor fornece uma ferramenta prática de diagnóstico para identificar quais camadas do ecossistema de IA são acessíveis a uma determinada organização, dados sua base de capital, suas capacidades técnicas e seus relacionamentos existentes. Organizações que não têm capital para competir nas camadas 1–3 podem, ainda assim, construir posições diferenciadas nas camadas 5–6, desde que invistam na profundidade de integração, no conhecimento de domínio e nos relacionamentos com usuários que constituem a fonte sustentável de vantagem competitiva na camada de aplicações. O erro estratégico crítico a evitar é confundir a baixa barreira de capital à entrada na camada 6 (qualquer desenvolvedor pode acessar um modelo de fundação via API) com uma baixa barreira a uma posição competitiva sustentável (poucas empresas da camada de aplicações alcançam diferenciação duradoura). O modelo da cadeia de valor torna essa distinção analiticamente precisa: barreiras de entrada baixas e fosso competitivo baixo são dimensões independentes, e confundi-las levou a excesso de investimento em aplicações de IA indiferenciadas e a falta de investimento nas capacidades de plataforma e orquestração que criam valor duradouro.
Por fim, a observação de que o valor migra para as camadas de coordenação e orquestração à medida que as capacidades dos modelos se tornam commodities tem relevância direta para o desenho de mercados eletrônicos e plataformas de negócios em rede. Mercados eletrônicos e plataformas B2B que integram capacidades de IA generativa como aprimoramento de funcionalidades podem se ver estruturalmente reposicionados à medida que a orquestração de IA se torna o principal mecanismo de coordenação dos fluxos de trabalho digitais corporativos. A implicação para o desenho de mercados digitais é que os donos de plataformas devem investir em inteligência de orquestração—roteamento, otimização, gestão de contexto, integração aos fluxos de trabalho—em vez de nas capacidades de IA subjacentes em si, que estão sujeitas a dinâmicas de comoditização já bem avançadas. Trata-se de um princípio de desenho fundamentado na análise estrutural da cadeia de valor, com implicações diretas para decisões de arquitetura de plataformas no domínio dos mercados eletrônicos e dos negócios em rede.
5.2. Implicações para a Teoria de Plataformas e a Economia da Inovação
Os resultados têm implicações específicas para a pesquisa sobre plataformas digitais e motivam três proposições formais que estendem a teoria existente ao contexto da IA com múltiplas camadas. Cada proposição está explicitamente fundamentada em uma tradição teórica anterior, e a contribuição é definida em termos do que o artigo acrescenta a essa tradição.
A teoria tradicional de plataformas foca em sistemas que coordenam interações entre múltiplos grupos de usuários por meio de uma interface tecnológica compartilhada (Gawer, 2014; Hagiu e Wright, 2015; Evans e Schmalensee, 2016; Gawer e Cusumano, 2002). Os exemplos clássicos—sistemas operacionais, marketplaces digitais, redes sociais—compartilham uma característica definidora: a plataforma central é uma infraestrutura de coordenação estável, cujas capacidades mudam lentamente em relação ao ecossistema que ela sustenta. A captura de valor deriva do controle do acesso, da participação e dos custos de troca na camada de interface. A teoria dos ativos complementares (Teece, 1986) estende essa lógica ao mostrar que o lucro da inovação não cabe ao inovador em si, mas a quem controla os ativos complementares necessários para levar as capacidades ao mercado. A teoria da arquitetura de ecossistemas (Jacobides et al., 2018) especifica ainda que a captura de valor depende do controle de gargalos arquiteturais—as interfaces, os padrões e as camadas de coordenação que os demais participantes não conseguem contornar.
A IA generativa se afasta dessas configurações de duas maneiras que a teoria existente não modela explicitamente. Primeiro, a capacidade central da plataforma é ela própria um sistema que aprende, cujas capacidades se difundem para sistemas concorrentes de forma relativamente rápida, violando o pressuposto de capacidade estática dos modelos de plataforma anteriores. Segundo, as propriedades relevantes para plataformas—multilateralidade, efeitos de rede, coordenação de complementadores—estão presentes simultaneamente em múltiplas camadas da pilha, e não apenas em uma única interface de coordenação. Essas diferenças estruturais motivam as proposições a seguir.
Proposição 1 (Deslocamento de plataforma impulsionado pela difusão): Em ecossistemas nos quais a capacidade central da plataforma é um sistema que aprende e está sujeito a rápida difusão, prevê-se que o locus do poder de plataforma migre, ao longo do tempo, da camada que controla a capacidade (a camada de modelos) para a camada que controla acesso, roteamento e integração (a camada de orquestração). Esse mecanismo estende a lógica de ativos complementares de Teece (1986) em uma direção específica: quando a própria inovação se difunde rapidamente, o ativo complementar relevante não é a fabricação nem a distribuição (como nos exemplos originais de Teece), mas a infraestrutura de coordenação e integração. A camada de orquestração é o ativo complementar que permanece escasso à medida que as capacidades dos modelos se tornam commodities. As evidências disponíveis são direcionalmente consistentes com essa previsão, mas ainda não estabelecem a trajetória dinâmica: os preços da camada de modelos caíram aproximadamente 1000× entre 2023 e 2025, enquanto mecanismos de monetização da camada de orquestração (por exemplo, taxas de roteamento da ordem de 5–5,5%) foram documentados em nível semelhante no mesmo período (Demirer et al., 2025). A proposição deve ser entendida como prospectiva—prevendo onde a vantagem competitiva se concentrará à medida que o ecossistema amadurece. Dados longitudinais que acompanhem as trajetórias de margem entre as camadas serão necessários para testá-la de forma definitiva.
Proposição 2 (Simultaneidade de plataformas em múltiplas camadas): Em ecossistemas de IA generativa, múltiplas camadas exibem características de plataforma simultaneamente—a camada de semicondutores exibe uma concentração do lado da oferta análoga a gargalos de plataforma; a camada de modelos faz a mediação entre fornecedores de computação e desenvolvedores de aplicações em uma configuração bilateral; a camada de orquestração coordena modelos e usuários em um mercado multilateral clássico. Essa configuração estende o referencial de arquitetura de ecossistemas de Jacobides et al. (2018), que identifica os gargalos arquiteturais como o principal locus de captura de valor, ao mostrar que, em ecossistemas de IA, o gargalo não está fixo em uma única camada, mas distribuído entre camadas simultaneamente—e que diferentes camadas exibem uma concentração semelhante à de gargalos por mecanismos diferentes (aprisionamento de hardware na camada 1, dependência do CUDA na camada 2, liderança de capacidade na camada 3, controle de roteamento na camada 5). Isso implica que a análise competitiva exige definições de mercado específicas por camada, e não caracterizações no nível do ecossistema, e que marcos regulatórios desenvolvidos para plataformas de interface única podem estar sistematicamente mal especificados para ecossistemas de IA com múltiplas camadas.
Proposição 3 (Prêmio de integração): Empresas que abrangem múltiplas camadas relevantes como plataforma podem capturar rendas de coordenação que, de outro modo, estariam distribuídas entre transações de mercado independentes. Esta proposição estende tanto Teece (1986) quanto Jacobides et al. (2018): de Teece, toma a ideia de que a captura de valor exige o controle de ativos complementares; de Jacobides et al., toma a ideia de que o controle arquitetural determina quem se apropria do excedente do ecossistema. A contribuição específica é o mecanismo de internalização de rendas: uma empresa que controla uma extensão suficiente da pilha não apenas reduz custos de transação (o argumento-padrão da integração vertical), mas converte a dependência entre camadas—que empresas de camada única vivenciam como uma restrição ao seu poder de preço—em fluxo de valor interno à empresa. O prêmio de integração cresce com o número de relações de transferência de valor entre camadas internalizadas. O caso do Google ilustra isso concretamente: TPUs e Cloud nas camadas 1–2, Gemini na camada 3, inferência via Google Cloud na camada 4 e Search/Android/Workspace nas camadas 5–6. Essa posição de pilha completa significa que o Google internaliza todas as principais transferências de valor entre camadas do ecossistema. Uma empresa que ocupe apenas as camadas 1–2 e 5–6, sem controlar as camadas 3–4, continuaria dependente de provedores externos de modelos no segmento estrategicamente mais disputado da pilha (Cusumano et al., 2019).
Essas três proposições representam avanços teóricos em relação ao trabalho existente. A Proposição 1 introduz um mecanismo dinâmico de ativos complementares ausente da formulação estática original de Teece. A Proposição 2 identifica uma configuração de múltiplos gargalos não captada pelo modelo de gargalo único de Jacobides et al. A Proposição 3 especifica uma justificativa de internalização de rendas para a integração vertical, distinta tanto da economia dos custos de transação quanto da justificativa de redução de custos. Em conjunto, elas fornecem uma base para trabalhos teóricos e empíricos futuros sobre governança de ecossistemas de IA, política de inovação e estratégia competitiva.
5.3. Implicações para a Política de Inovação e a Estrutura Competitiva
O modelo de seis camadas e as três proposições apresentadas na seção anterior têm implicações diretas para a política de inovação, a regulação de mercados e a estrutura competitiva de setores intensivos em IA.
A primeira implicação diz respeito à regulação dos mercados de computação. A análise da H2 mostra que a concentração extrema na oferta de GPUs—sustentada em parte pela pilha de software CUDA como mecanismo complementar de aprisionamento—cria um gargalo estrutural que condiciona as dinâmicas de inovação ao longo de toda a cadeia de valor. Não se trata de um problema-padrão de monopólio (um único vendedor formador de preços em um mercado estável), mas de um problema de gargalo dinâmico, no qual o incumbente extrai rendas durante uma janela transitória de liderança tecnológica enquanto a inovação a jusante é efetivamente tributada. A resposta de política adequada não são os remédios antitruste convencionais, que tratam de poder de mercado estático, mas exigências de interoperabilidade e padrões de interface aberta para a infraestrutura de computação de IA—instrumentos mais análogos às políticas de desagregação de redes (*unbundling*) aplicadas à infraestrutura de telecomunicações (Dosi, 1982; Pavitt, 1984).
A segunda implicação diz respeito aos efeitos distributivos dos ganhos de produtividade da IA. As evidências da H6 mostram que os ganhos de produtividade são reais e substanciais, mas a análise que conecta a H6 à estrutura da cadeia de valor revela que esses ganhos chegam aos usuários finais por meio de camadas-gargalo específicas (inferência e aplicações). Se a concentração de computação (H2) persistir e a dependência de plataformas (H5) se intensificar, os termos em que as ferramentas de IA que aumentam a produtividade estarão acessíveis serão definidos por intermediários capazes de extrair rendas do lado da demanda. Isso implica que uma política de inovação voltada a garantir amplo acesso aos ganhos de produtividade da IA deve tratar da estrutura do lado da oferta da cadeia de valor, e não apenas da existência de capacidades de IA.
A terceira implicação diz respeito às dinâmicas industriais dos ecossistemas de IA. Seguindo o referencial de Pavitt (1984) para padrões setoriais de mudança técnica, a cadeia de valor da IA generativa exibe características de ao menos dois regimes pavittianos distintos simultaneamente: as camadas de semicondutores e de infraestrutura se assemelham ao regime *intensivo em escala* (altos custos fixos, concentração, inovação incremental impulsionada por investimento de capital), enquanto as camadas de modelos e de aplicações se assemelham ao regime *intensivo em informação* (difusão rápida, barreiras de entrada baixas, inovação impulsionada por conhecimento organizacional). Essa coexistência de regimes em uma única cadeia de valor é uma novidade estrutural que cria dinâmicas de inovação próprias—incluindo o descolamento entre intensidade de capital e captura de valor documentado neste artigo—e merece investigação empírica dedicada à medida que o mercado amadurece.
Referencial de posicionamento por camada. As seis camadas diferem ao longo de três dimensões estrategicamente relevantes: intensidade de capital para entrada, durabilidade da vantagem competitiva e grau de dependência de plataformas. A Tabela 8 organiza essas dimensões ao longo da cadeia de valor como referência tanto para pesquisadores que desenham estudos empíricos por camada quanto para profissionais que tomam decisões de posicionamento.
*Tabela 8. Referencial de posicionamento por camada: dimensões estratégicas ao longo da cadeia de valor da IA generativa.*
| Camada | Intensidade de capital para entrada | Durabilidade da vantagem | Base principal da competição |
|---|---|---|---|
| Semicondutores / Hardware | Extremamente alta | Alta (aprisionamento de fabricação, ecossistema CUDA) | Arquitetura proprietária, acesso à fabricação, aprisionamento de software |
| Infraestrutura de nuvem | Muito alta | Moderada-alta (economias de escala) | Escala de infraestrutura, custo de energia, cobertura geográfica |
| Desenvolvimento de modelos de fundação | Alta | Baixa-moderada (difusão rápida) | Velocidade de pesquisa, acesso a dados, reputação em segurança |
| Inferência / disponibilização de modelos | Moderada | Baixa (competição por preço) | Eficiência de custos, latência, variedade de modelos |
| Plataformas / orquestração | Baixa-moderada | Alta se os efeitos de rede se estabelecerem | Controle de roteamento, padronização de APIs, aprisionamento de desenvolvedores |
| Aplicações | Baixa | Baixa (entrada competitiva) | Conhecimento de domínio, integração aos fluxos de trabalho, retenção de usuários |
Esse referencial produz três arquétipos estratégicos. *Incumbentes de infraestrutura* (por exemplo, NVIDIA e os principais hyperscalers) competem em profundidade de capital e na engenharia de custos de troca; seu fosso é estrutural, e não tecnológico. *Competidores de modelos* (por exemplo, OpenAI, Anthropic, Google DeepMind) competem em velocidade de pesquisa, mas enfrentam rápida difusão de capacidades; a diferenciação sustentável exige investimento contínuo na fronteira ou migração para orquestração e controle de plataforma. *Especialistas em aplicações* enfrentam barreiras de entrada baixas, mas também fosso baixo; sua vantagem sustentável está na profundidade de integração ao domínio e na retenção de usuários, e não na capacidade de IA em si, cada vez mais disponível como insumo de commodity.
A tabela atribui alta durabilidade da vantagem à camada de plataformas e orquestração condicionada ao estabelecimento de efeitos de rede—uma condição que requer maior elaboração. Os efeitos de rede em plataformas de orquestração de IA surgem por dois mecanismos distintos. O primeiro é o *acúmulo do lado dos dados*: uma plataforma de roteamento que processa um grande volume de requisições entre muitos modelos e casos de uso acumula informações sobre desempenho dos modelos, preços e preferências dos usuários que rivais de menor volume não conseguem replicar, criando uma assimetria informacional que se acumula ao longo do tempo. O segundo é o *aprisionamento de complementadores*: à medida que os desenvolvedores constroem fluxos de trabalho, integrações e cadeias de ferramentas sobre as APIs e abstrações de uma plataforma de orquestração específica, o custo de troca para migrar para uma plataforma alternativa cresce com a profundidade da integração. Esses mecanismos são estruturalmente análogos aos efeitos de rede documentados em ecossistemas de plataforma anteriores (Gawer, 2014; Hagiu e Wright, 2015), mas operam em uma camada diferente e com uma temporalidade diferente: acumulam-se gradualmente à medida que o ecossistema cresce, em vez de surgirem no lançamento. Isso implica que plataformas de orquestração pioneiras que alcancem adoção suficiente entre desenvolvedores podem estabelecer posições duradouras, enquanto entrantes tardios enfrentam o clássico problema do ovo e da galinha das plataformas, mesmo em um mercado tecnicamente maduro.
Organizações que competem na camada de infraestrutura precisam investir pesadamente em capacidade de computação, data centers e hardware especializado. Esses investimentos exigem grandes comprometimentos de capital, mas podem se beneficiar de economias de escala (NVIDIA Corporation, 2024). As empresas que atuam nessa camada, portanto, tendem a ser grandes empresas de tecnologia ou empresas especializadas em semicondutores.
Organizações que competem na camada de modelos precisam investir em pesquisa em aprendizado de máquina, infraestrutura de treinamento e recursos de dados. As evidências empíricas demonstram que as capacidades nessa camada se difundem de forma relativamente rápida, uma vez que as técnicas se tornam amplamente conhecidas (Demirer et al., 2025; Cusumano, 2025). Como resultado, sustentar a diferenciação de longo prazo pode exigir investimento contínuo em pesquisa e infraestrutura, ou uma migração estratégica para posições de plataforma e orquestração.
A camada de aplicações, por outro lado, permite a entrada com investimento de capital muito menor. Os desenvolvedores podem acessar as capacidades dos modelos por meio de APIs ou de modelos de pesos abertos (Cusumano et al., 2025). Isso viabiliza experimentação rápida e o desenvolvimento de aplicações especializadas em diversos setores. No entanto, os desenvolvedores de aplicações podem depender fortemente dos provedores de modelos a montante e das interfaces de plataforma; a sustentabilidade de sua posição competitiva depende de fatores ortogonais à capacidade de IA—distribuição, confiança e integração aos fluxos de trabalho.
O modelo de seis camadas também ilumina a lógica estratégica da integração vertical ao longo da pilha. Uma empresa que compete em múltiplas camadas simultaneamente não precisa maximizar a margem em cada camada de forma independente. Em vez disso, pode usar a propriedade das camadas inferiores para subsidiar ou fortalecer sua posição nas camadas superiores, e usar os relacionamentos das camadas superiores para capturar dados, feedback e sinais de uso que reforçam vantagens nas camadas inferiores. Essa consolidação de posição entre camadas pode produzir vantagens competitivas duradouras que empresas de camada única não conseguem replicar, mesmo que essas empresas sejam tecnicamente competitivas dentro de sua própria camada.
A posição vertical do Google no ecossistema de IA generativa ilustra essa lógica concretamente. O Google projeta e opera suas próprias Tensor Processing Units (TPUs) na camada de semicondutores e infraestrutura, reduzindo sua dependência da cadeia de suprimentos de GPUs da NVIDIA e obtendo vantagens de custo e latência no treinamento e na inferência de modelos (NVIDIA Corporation, 2024). Na camada de modelos, o Google desenvolve o Gemini e sistemas de fronteira relacionados, competindo diretamente com a OpenAI e a Anthropic. Na camada de plataforma e aplicações, o Google controla o Search, o Android, o Chrome e o Workspace—superfícies de distribuição que lhe permitem levar capacidades de IA a bilhões de usuários sem depender de intermediários terceiros. Essa extensão vertical significa que o Google pode aceitar margens abaixo das de mercado em qualquer camada individual, porque o valor de sua posição deriva do sistema integrado, e não de um componente isolado. Uma empresa que compete apenas no desenvolvimento de modelos ou apenas em aplicações enfrenta o Google não apenas como rival em sua própria camada, mas como um integrador de sistemas cuja estrutura de custos e cujo *flywheel* de dados—o ciclo autorreforçador no qual o uso gera dados que melhoram o produto e atraem mais uso—se estendem por toda a pilha (Cusumano et al., 2019; Bommasani et al., 2021).
Essa observação estrutural estende a H5. A hipótese afirma que as camadas de plataforma estão posicionadas para capturar uma parcela desproporcional do valor do ecossistema por meio de mecanismos de coordenação e roteamento. A integração vertical entre camadas sugere um mecanismo relacionado, mas distinto: empresas que abrangem múltiplas camadas podem internalizar fluxos de valor que, de outro modo, estariam distribuídos entre transações de mercado independentes. Nessa configuração, a questão de qual camada é mais valiosa se torna secundária em relação à questão de qual empresa controla mais camadas simultaneamente. A vantagem estratégica da integração de pilha completa é justamente converter a dependência entre camadas—que empresas de camada única vivenciam como uma restrição—em um ativo interno à empresa.
Essas diferenças estruturais implicam que as empresas precisam alinhar sua estratégia às suas capacidades e recursos. Organizações com bases de capital fortes e experiência em infraestrutura podem buscar expandir-se por múltiplas camadas da cadeia de valor, como ilustram os investimentos em infraestrutura dos principais provedores de nuvem. Empresas menores podem focar em aplicações especializadas ou serviços específicos de domínio construídos sobre APIs de modelos de fundação, competindo em profundidade de integração, e não em capacidade de IA propriamente dita.
5.4. Limitações das Evidências Atuais
Quatro limitações devem ser consideradas ao interpretar os resultados deste estudo.
Primeiro, o ecossistema de IA generativa está evoluindo rapidamente. Muitos dos padrões de mercado descritos neste artigo se baseiam em observações recentes que podem mudar à medida que o setor amadurece.
Segundo, a literatura empírica disponível oferece visibilidade limitada sobre a alocação de lucros ao longo da cadeia de valor da IA generativa. Embora os estudos documentem custos de infraestrutura, tendências de preço e efeitos de produtividade, poucos fornecem evidências diretas sobre margens de longo prazo ou captura de valor entre as camadas da cadeia de valor.
Terceiro, o modelo de seis camadas exclui diversos fenômenos que podem ser relevantes para os resultados competitivos. Ele não capta assimetrias dentro de uma mesma camada: na camada de aplicações, a posição estratégica de uma aplicação de consumo que atende milhões de usuários difere fundamentalmente da de uma aplicação corporativa que atende setores regulados, e, no entanto, ambas aparecem na mesma camada do modelo. Não capta a convergência entre camadas: um modelo de fundação que desempenha funções de inferência, orquestração e aplicação simultaneamente—como modelos cada vez mais capazes estão começando a fazer—desfaz a distinção entre as camadas 3, 4 e 5, tornando as fronteiras entre camadas analiticamente fluidas. E não capta a não integração deliberada: empresas que recusam a integração vertical por razões de posicionamento no ecossistema, risco regulatório ou estratégia de parcerias podem alcançar resultados que a lógica do prêmio de integração não preveria. Trabalhos empíricos que refinem o modelo devem tratar essas condições de contorno como questões de pesquisa em aberto.
Quarto, todas as decisões de triagem e seleção na revisão sistemática foram tomadas por um único revisor. A ausência de um segundo revisor independente representa uma limitação do protocolo da revisão e pode introduzir viés de seleção não intencional. Replicações futuras desta revisão devem empregar procedimentos com múltiplos revisores para aumentar o rigor metodológico.
Cada limitação aponta para uma direção específica de trabalho empírico adicional à medida que o setor amadurece.
5.5. Direções para Pesquisas Futuras
Os resultados deste estudo apontam para quatro direções de pesquisa futura.
Primeiro, estudos subsequentes devem construir contas financeiras por camada da cadeia de valor da IA generativa. Dados de receita e margem no nível das empresas, desagregados por segmentos de infraestrutura, modelos, plataformas e aplicações, permitiriam a mensuração direta de onde os lucros se acumulam e de como essa distribuição muda à medida que o mercado amadurece.
Segundo, os pesquisadores devem analisar a dinâmica competitiva dos mercados de modelos de fundação. À medida que surgem novas arquiteturas e técnicas de treinamento, não está claro se o mercado convergirá para um pequeno número de modelos dominantes ou permanecerá fragmentado.
Terceiro, são necessárias pesquisas adicionais sobre os efeitos de produtividade de longo prazo da adoção de IA generativa. Os estudos existentes medem o desempenho em tarefas de curto prazo, mas os efeitos de longo prazo sobre a produtividade organizacional e os mercados de trabalho permanecem incertos.
Por fim, os ecossistemas de IA generativa oferecem um campo empírico produtivo para estender as teorias existentes sobre plataformas digitais e ecossistemas tecnológicos. Compreender como a coordenação, a inovação e a captura de valor evoluem nesses ecossistemas de múltiplas camadas continua sendo um desafio teórico em aberto.
6. Conclusão
6.1. Síntese dos Resultados
Este artigo examinou a estrutura econômica do ecossistema de IA generativa por meio de uma análise sistemática de 36 estudos—20 trabalhos revisados por pares (artigos em periódicos, artigos em conferências e livros acadêmicos) e 16 fontes de literatura cinzenta (working papers do NBER, preprints do arXiv e relatórios técnicos institucionais)—organizados em torno de um modelo de seis camadas da cadeia de valor e avaliados à luz de seis hipóteses estruturais.
Quatro hipóteses foram confirmadas pelas evidências empíricas disponíveis. A intensidade de capital está concentrada nas camadas de infraestrutura e de treinamento de fronteira (H1), em consonância com a pesquisa sobre leis de escala e com os dados de custo de infraestrutura. As melhorias de capacidade se difundem rapidamente pelas camadas de modelos e de inferência, comprimindo preços em ordens de grandeza e corroendo a exclusividade técnica (H3). As barreiras de entrada são substancialmente menores na camada de aplicações, permitindo um rápido crescimento do ecossistema construído sobre capacidades de modelos acessíveis por API (H4). A IA generativa produz ganhos de produtividade mensuráveis e heterogêneos no trabalho do conhecimento, com tamanhos de efeito que variam de 14% a 55% em múltiplos contextos experimentais (H6) (Noy e Zhang, 2023; Peng et al., 2023; Brynjolfsson et al., 2023; Dell'Acqua et al., 2023).
Uma hipótese foi parcialmente confirmada. A oferta de computação é altamente concentrada—particularmente nos níveis de hardware e de treinamento de fronteira—, mas a concentração não é absoluta nem irreversível; a competição na camada de inferência já é mais plural, e os hyperscalers estão investindo em alternativas proprietárias (H2) (NVIDIA Corporation, 2024; Demirer et al., 2025).
Uma hipótese tem fundamentação teórica, mas é empiricamente incompleta. As camadas de orquestração de plataformas têm a base teórica mais forte para a captura de valor à medida que as capacidades dos modelos se tornam commodities, e os mecanismos de coordenação observáveis são consistentes com essa previsão; no entanto, dados diretos de lucro entre camadas suficientes para uma verificação definitiva ainda não estão disponíveis (H5) (Gawer, 2014; Demirer et al., 2025).
Dois resultados adicionais estendem os resultados centrais. Primeiro, a concentração na camada de computação reflete uma janela temporalmente delimitada, moldada por custos de troca baseados no CUDA e por um comportamento de preços consistente com a extração de rendas sob competição antecipada, e não um equilíbrio estável. Segundo, a integração vertical entre múltiplas camadas da pilha converte a dependência entre camadas em fluxo de valor interno à empresa, produzindo vantagens competitivas que nenhum competidor de camada única consegue replicar apenas com excelência técnica. Ambos os resultados devem ser entendidos como observações estruturais fundamentadas em teoria, e não como conclusões verificadas empiricamente: dados de lucro entre camadas e resultados competitivos de longo prazo ainda não estão disponíveis.
6.2. Contribuições Teóricas
Este artigo faz três contribuições à literatura.
Primeiro, propõe um modelo conceitual de seis camadas da cadeia de valor da IA generativa que integra contribuições da pesquisa sobre leis de escala, da economia de plataformas e da tradição dos estudos de inovação sobre padrões setoriais de mudança técnica (Pavitt, 1984; Dosi, 1982). O modelo identifica uma novidade estrutural—a coexistência de regimes de inovação intensivos em escala e intensivos em informação em uma única cadeia de valor—que trabalhos anteriores sobre IA não caracterizaram sistematicamente. Embora estudos anteriores tenham examinado componentes individuais do ecossistema, nenhum analisou como essas camadas interagem em uma estrutura unificada que dê conta de suas distintas intensidades de capital, dinâmicas competitivas e mecanismos de captura de valor.
Segundo, oferece uma avaliação empírica de seis hipóteses estruturais com base em um corpus sistemático de 36 estudos, distinguindo entre afirmações sustentadas por evidências revisadas por pares, afirmações sustentadas por literatura cinzenta e working papers (tratadas como indicativas) e afirmações que permanecem fundamentadas teoricamente, mas empiricamente incompletas. Esse tratamento disciplinado da incerteza das evidências é, em si, uma contribuição metodológica à literatura emergente sobre a estrutura de mercado da IA, na qual o ritmo de desenvolvimento ultrapassou a publicação revisada por pares.
Terceiro, estende a teoria de plataformas e o referencial de ativos complementares ao contexto da IA generativa com múltiplas camadas por meio de três proposições formais. A Proposição 1 avança a lógica de ativos complementares de Teece (1986) ao identificar a infraestrutura de coordenação como o ativo complementar relevante em ecossistemas de sistemas que aprendem e se difundem rapidamente. A Proposição 2 estende o modelo de ecossistema de gargalo único de Jacobides et al. (2018) para uma configuração de múltiplos gargalos, na qual diferentes camadas exibem concentração por mecanismos diferentes. A Proposição 3 especifica um mecanismo de internalização de rendas para a integração vertical, distinto tanto da economia dos custos de transação quanto das justificativas de redução de custos, levando a lógica de controle arquitetural da teoria de ecossistemas às cadeias de valor de IA. Em conjunto, essas proposições fornecem uma base teoricamente fundamentada para trabalhos empíricos futuros sobre governança de ecossistemas de IA, política de inovação e estratégia competitiva.
6.3. Implicações para a Pesquisa e a Indústria
Os resultados deste estudo têm implicações diretas tanto para a pesquisa quanto para a prática.
Para os pesquisadores, o ecossistema de IA generativa oferece um campo empírico produtivo para estender as teorias existentes sobre plataformas digitais e ecossistemas tecnológicos. As evidências aqui apresentadas demonstram que a IA generativa introduz uma arquitetura de múltiplas camadas na qual diferentes camadas exibem dinâmicas competitivas distintas. Compreender como essas camadas interagem e coevoluem continua sendo um desafio teórico em aberto.
Para os profissionais da indústria, os resultados esclarecem a lógica estratégica do posicionamento por camada na cadeia de valor da IA generativa. Empresas que competem em infraestrutura ou no desenvolvimento de modelos precisam sustentar grandes investimentos de capital, enquanto empresas que atuam nas camadas de aplicações a jusante podem se beneficiar de barreiras de entrada menores, mas enfrentam maior pressão competitiva. As camadas de orquestração de plataformas tendem a se tornar estrategicamente mais centrais à medida que o setor cresce em complexidade.
Agradecimentos
Esta pesquisa foi realizada como parte das atividades estendidas de pesquisa e residência do autor na Sloan School of Management, no âmbito do Visiting Fellows Program do Massachusetts Institute of Technology (MIT). O autor, professor e pesquisador da CESAR School (Recife Center for Advanced Studies and Systems), agradece o ambiente acadêmico e o diálogo interdisciplinar que sustentaram o desenvolvimento intelectual deste estudo.
Referências
- Acemoglu, Daron, and Restrepo, Pascual (2019). Automation and New Tasks: How Technology Displaces and Reinstates Labor. *Journal of Economic Perspectives*, 33(2):3–30. https://doi.org/10.1257/jep.33.2.3
- Agrawal, Ajay, Gans, Joshua, and Goldfarb, Avi (2018). *Prediction Machines: The Simple Economics of Artificial Intelligence*. Harvard Business Review Press, Boston, MA.
- Anthropic (2023). Claude's Model Card. Technical Report, Anthropic. Available: https://www.anthropic.com/claude.
- Bender, Emily M., Gebru, Timnit, McMillan-Major, Angelina, and Shmitchell, Shmargaret (2021). On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? In *Proceedings of the ACM Conference on Fairness, Accountability, and Transparency*, pages 610–623.
- Bommasani, Rishi, Hudson, Drew A., Adeli, Ehsan, et al. (2021). On the Opportunities and Risks of Foundation Models. arXiv preprint arXiv:2108.07258.
- Bommasani, Rishi, et al. (2023). The Foundation Model Transparency Index. Technical Report, Stanford Center for Research on Foundation Models (CRFM). Available: https://crfm.stanford.edu/fmti.
- Brown, Tom B., Mann, Benjamin, Ryder, Nick, Subbiah, Melanie, Kaplan, Jared, et al. (2020). Language Models are Few-Shot Learners. In *Advances in Neural Information Processing Systems*, volume 33, pages 1877–1901.
- Brynjolfsson, Erik, Rock, Daniel, and Syverson, Chad (2017). Artificial Intelligence and the Modern Productivity Paradox: A Clash of Expectations and Statistics. Working Paper 24001, National Bureau of Economic Research.
- Brynjolfsson, Erik, Li, Danielle, and Raymond, Lindsey (2023). Generative AI at Work. Working Paper 31161, National Bureau of Economic Research.
- Cockburn, Iain M., Henderson, Rebecca, and Stern, Scott (2018). The Impact of Artificial Intelligence on Innovation. Working Paper 24449, National Bureau of Economic Research.
- Cusumano, Michael A., Gawer, Annabelle, and Yoffie, David B. (2019). *The Business of Platforms*. Harper Business, New York, NY.
- Cusumano, Michael A., Farias, Vivek, and Ramakrishnan, Rama (2025). Generative AI as a Platform for Applications Development. MIT CISR Research Briefing; forthcoming in *Communications of the ACM*.
- Cusumano, Michael A. (2025). The DeepSeek Moment: Strategic Implications for AI Platforms. Forthcoming in *Communications of the ACM*.
- Dell'Acqua, Fabrizio, McFowland III, Edward, Mollick, Ethan R., Lifshitz-Assaf, Hila, Kellogg, Katherine, Rajendran, Saran, Krayer, Lisa, Candelon, François, and Lakhani, Karim R. (2023). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of AI on Knowledge Worker Productivity and Quality. Working Paper 24-013, Harvard Business School.
- Demirer, Mert, Fradkin, Andrey, and Peng, Sida (2025). The Emerging Market for Intelligence: Pricing, Supply, and Demand for LLMs. Working Paper 34608, National Bureau of Economic Research.
- Dosi, Giovanni (1982). Technological Paradigms and Technological Trajectories. *Research Policy*, 11(3):147–162. https://doi.org/10.1016/0048-7333(82)90016-6
- Evans, David S., and Schmalensee, Richard (2016). *Matchmakers: The New Economics of Multisided Platforms*. Harvard Business Review Press, Boston, MA.
- Gawer, Annabelle, and Cusumano, Michael A. (2002). *Platform Leadership: How Intel, Microsoft, and Cisco Drive Industry Innovation*. Harvard Business School Press, Boston, MA.
- Gawer, Annabelle (2014). Bridging Differing Perspectives on Technological Platforms: Toward an Integrative Framework. *Research Policy*, 43(7):1239–1249. https://doi.org/10.1016/j.respol.2014.03.003
- Goodfellow, Ian, Bengio, Yoshua, and Courville, Aaron (2016). *Deep Learning*. MIT Press, Cambridge, MA.
- Hagiu, Andrei, and Wright, Julian (2015). Multi-Sided Platforms. *International Journal of Industrial Organization*, 43:162–174. https://doi.org/10.1016/j.ijindorg.2015.09.005
- Hoffmann, Jordan, Borgeaud, Sebastian, Mensch, Arthur, Buchatskaya, Elena, Cai, Trevor, Rutherford, Eliza, et al. (2022). Training Compute-Optimal Large Language Models. arXiv preprint arXiv:2203.15556.
- Jacobides, Michael G., Cennamo, Carmelo, and Gawer, Annabelle (2018). Towards a Theory of Ecosystems. *Strategic Management Journal*, 39(8):2255–2276. https://doi.org/10.1002/smj.2904
- Jordan, Michael I., and Mitchell, Tom M. (2015). Machine Learning: Trends, Perspectives, and Prospects. *Science*, 349(6245):255–260. https://doi.org/10.1126/science.aaa8415
- Kaplan, Jared, McCandlish, Sam, Henighan, Tom, Brown, Tom, Chess, Benjamin, Child, Rewon, Gray, Scott, Radford, Alec, Wu, Jeffrey, and Amodei, Dario (2020). Scaling Laws for Neural Language Models. arXiv preprint arXiv:2001.08361.
- LeCun, Yann, Bengio, Yoshua, and Hinton, Geoffrey (2015). Deep Learning. *Nature*, 521(7553):436–444. https://doi.org/10.1038/nature14539
- Noy, Shakked, and Zhang, Whitney (2023). Experimental Evidence on the Productivity Effects of Generative Artificial Intelligence. *Science*, 381(6654):187–192. https://doi.org/10.1126/science.adh2586
- NVIDIA Corporation (2024). Annual Report, Fiscal Year 2024. Technical Report, NVIDIA Corporation. Available: https://investor.nvidia.com/financial-information/annual-reports/.
- OpenAI (2023). GPT-4 Technical Report. arXiv preprint arXiv:2303.08774.
- Patterson, David, Gonzalez, Joseph, Le, Quoc, Liang, Chen, Munguia, Lluis, Rothchild, Daniel, So, David, Texier, Maud, and Dean, Jeff (2022). Carbon Emissions and Large Neural Network Training. *IEEE Micro*, 42(4):59–68. https://doi.org/10.1109/MM.2022.3163226
- Pavitt, Keith (1984). Sectoral Patterns of Technical Change: Towards a Taxonomy and a Theory. *Research Policy*, 13(6):343–373. https://doi.org/10.1016/0048-7333(84)90018-0
- Peng, Sida, Kalliamvakou, Eirini, Cihon, Peter, and Demirer, Mert (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot. arXiv preprint arXiv:2302.06590.
- Teece, David J. (1986). Profiting from Technological Innovation: Implications for Integration, Collaboration, Licensing and Public Policy. *Research Policy*, 15(6):285–305. https://doi.org/10.1016/0048-7333(86)90027-2
- Varian, Hal (2018). Artificial Intelligence, Economics, and Industrial Organization. Working Paper 24839, National Bureau of Economic Research.
- Vaswani, Ashish, Shazeer, Noam, Parmar, Niki, Uszkoreit, Jakob, Jones, Llion, Gomez, Aidan N., Kaiser, Lukasz, and Polosukhin, Illia (2017). Attention Is All You Need. In *Advances in Neural Information Processing Systems*, volume 30, pages 5998–6008.
- Weidinger, Laura, Mellor, John, Rauh, Maribeth, Griffin, Conor, et al. (2022). Taxonomy of Risks Posed by Language Models. In *Proceedings of the ACM Conference on Fairness, Accountability, and Transparency*, pages 214–229. https://doi.org/10.1145/3531146.3533088
Comentários
Todo comentário passa por moderação antes de aparecer aqui. Nada é publicado automaticamente.
Carregando…