 CARLOS DIEGO C. P.
Technical Post · Amazon Web Services
Implementing Monitoring for N-Tier Applications on AWS
N-Tier architecture is a software design model that splits an application into distinct logical layers, also known as…
Keywords
N-Tier architecture is a software design model that splits an application into distinct logical layers, also known as “layers” or “tiers,” where each layer performs specific functions and communicates with the other layers through well-defined interfaces. The “N” in N-Tier stands for the number of tiers, which can vary with the complexity and requirements of the application.
To automate monitoring for an N-Tier application using Terraform and the Amazon Web Services (AWS) services mentioned (Amazon Route53, Amazon S3, Amazon EC2 and Amazon RDS), we can build a basic infrastructure scenario with a Load Balancer, EC2 instances in an Auto Scaling Group and an RDS database, and set up monitoring with Amazon CloudWatch. I'll walk you through implementing this scenario with Terraform.
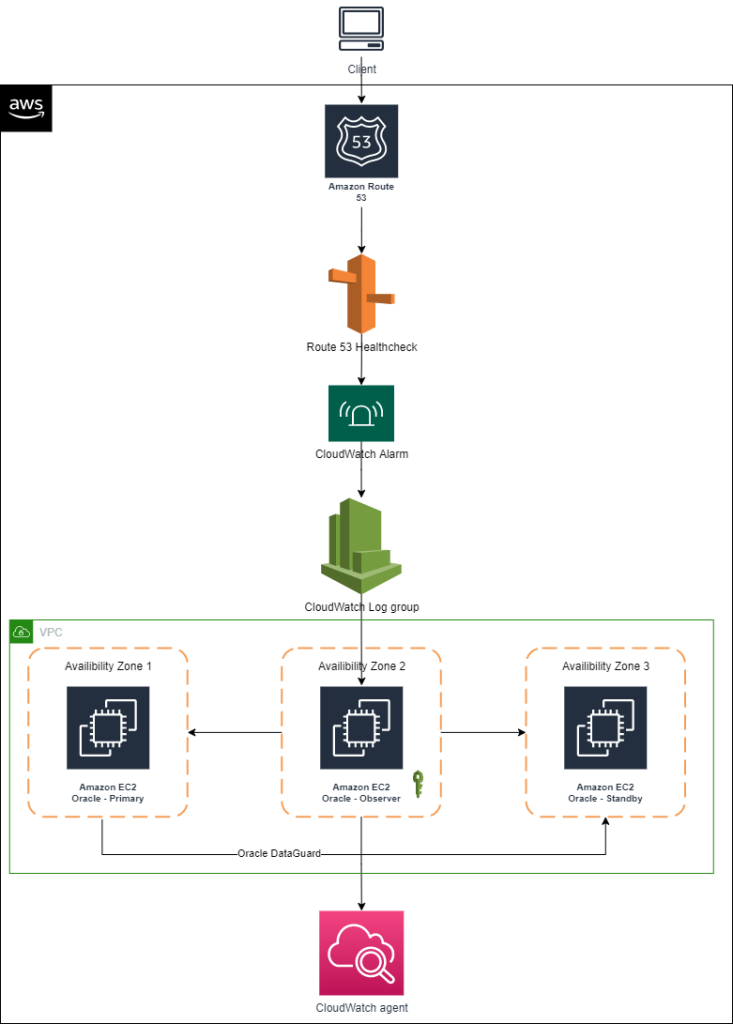
Before you start, make sure Terraform is installed on your machine and your AWS credentials are configured. Now let's write the Terraform code for this automation:
Create a file named main.tf with the following initial content:
provider "aws" {
  region = "us-east-1" # Defina a região desejada da AWS
}

# Defina suas variáveis de ambiente aqui, como nome do projeto, tags, etc.
Create a DNS zone in Amazon Route53 for your domain. Replace “seu-dominio.com” with your actual domain.
resource "aws_route53_zone" "main" {
  name = "seu-dominio.com"
}
resource "aws_route53_record" "www" {
  zone_id = aws_route53_zone.main.zone_id
  name    = "www.seu-dominio.com"
  type    = "A"
  alias {
    name                   = "seu-load-balancer-dns" # Substitua pelo DNS do Load Balancer posteriormente criado
    zone_id                = aws_lb.front_end.zone_id
    evaluate_target_health = true
  }
}
resource "aws_route53_record" "root" {
  zone_id = aws_route53_zone.main.zone_id
  name    = "seu-dominio.com"
  type    = "A"
  alias {
    name                   = "seu-load-balancer-dns" # Substitua pelo DNS do Load Balancer posteriormente criado
    zone_id                = aws_lb.front_end.zone_id
    evaluate_target_health = true
  }
}
Create an Amazon S3 bucket to store the Load Balancer logs:
resource "aws_s3_bucket" "lb_logs" {
  bucket = "seu-nome-do-bucket-logs" # Substitua pelo nome do bucket que você deseja
  acl    = "log-delivery-write"
}
resource "aws_lb" "front_end" {
  name               = "seu-nome-do-load-balancer" # Substitua pelo nome do load balancer
  internal           = false
  load_balancer_type = "application"
  subnets = ["subnet-1", "subnet-2", "subnet-3"] # Substitua pelas IDs das suas subnets públicas
  access_logs {
    bucket = aws_s3_bucket.lb_logs.bucket
  }
}
resource "aws_lb_target_group" "front_end" {
  name     = "seu-nome-do-target-group" # Substitua pelo nome do target group
  port     = 80
  protocol = "HTTP"
  vpc_id   = "sua-vpc-id" # Substitua pela ID da sua VPC
  health_check {
    path                = "/"
    protocol            = "HTTP"
    matcher             = "200-299"
    interval            = 30
    timeout             = 5
    healthy_threshold   = 2
    unhealthy_threshold = 2
  }
}
Create an EC2 instance using an Auto Scaling Group:
resource "aws_launch_configuration" "app_launch_config" {
  name_prefix   = "app-launch-config"
  image_id      = "ami-xxxxxxxxxxxxxxxxx" # Substitua pelo ID da imagem EC2 que você deseja usar
  instance_type = "t2.micro"
  security_groups = [
    "seu-security-group-id", # Substitua pelo ID do security group permitindo tráfego HTTP
  ]
  user_data = <<-EOF
              #!/bin/bash
              echo "Hello from EC2 instance!"
              EOF
}
resource "aws_autoscaling_group" "app_asg" {
  name                 = "seu-auto-scaling-group"
  max_size             = 2
  min_size             = 1
  desired_capacity     = 1
  launch_configuration = aws_launch_configuration.app_launch_config.name
  target_group_arns    = [aws_lb_target_group.front_end.arn]
  vpc_zone_identifier  = ["subnet-1", "subnet-2", "subnet-3"] # Substitua pelas IDs das suas subnets públicas
}
Create an RDS instance (database) with Amazon RDS:
resource "aws_db_subnet_group" "rds_subnet_group" {
  name       = "seu-rds-subnet-group"
  subnet_ids = ["subnet-4", "subnet-5", "subnet-6"] # Substitua pelas IDs das suas subnets privadas
}
resource "aws_db_instance" "rds_instance" {
  identifier           = "seu-nome-do-banco-de-dados"
  allocated_storage    = 20
  engine               = "mysql" # Substitua pelo banco de dados que deseja utilizar (ex: "mysql", "postgres", etc.)
  instance_class       = "db.t2.micro"
  name                 = "seu-nome-do-banco-de-dados"
  username             = "seu-usuario-do-banco"
  password             = "sua-senha-do-banco"
  db_subnet_group_name = aws_db_subnet_group.rds_subnet_group.name
}
Setting up monitoring with Amazon CloudWatch:
resource "aws_cloudwatch_metric_alarm" "high_cpu_utilization" {
  alarm_name          = "high-cpu-utilization"
  comparison_operator = "GreaterThanOrEqualToThreshold"
  evaluation_periods  = "2"
  metric_name         = "CPUUtilization"
  namespace           = "AWS/EC2"
  period              = "60"
  statistic           = "Average"
  threshold           = "70"
  alarm_description   = "This metric checks for high CPU utilization"
  alarm_actions       = ["arn:aws:sns:us-east-1:123456789012:your-sns-topic"]
  dimensions = {
    InstanceId = aws_instance.ec2_instance.id
  }
}
resource "aws_cloudwatch_metric_alarm" "rds_high_cpu_utilization" {
  alarm_name          = "rds-high-cpu-utilization"
  comparison_operator = "GreaterThanOrEqualToThreshold"
  evaluation_periods  = "2"
  metric_name         = "CPUUtilization"
  namespace           = "AWS/RDS"
  period              = "60"
  statistic           = "Average"
  threshold           = "70"
  alarm_description   = "This metric checks for
See you in the next post! =)
Comments
Every comment is moderated before it appears here. Nothing is published automatically.
Loading…